신뢰성 있는 메모리 구조를 만드는 방법
지난 글에서, DRAM은 그 자체로 정보를 저장하는 데 있어 불완전한 구조를 갖고 있어 끊임없이 리프레시를 해서 그 정보를 동적으로 유지시키는 방식을 소개하였다.
이러한 노력에도 불구하고, 데이터를 읽는데 있어서 여전히 오류의 가능성이 존재한다. 이는 데이터를 온전히 저장하는 것과는 별개로, 온전히 저장했다 하더라도 데이터를 읽는 과정에서 어떠한 원인에 의해서 오류가 발생할 수 있다.
오류의 원인과는 상관 없이 이러한 문제는 생각보다 자주, 전역적으로 발생한다. DRAM이 아무리 빨라도, 그 정보가 잘못된 정보라면 의미가 없다. 신뢰성 있는 메모리 구조를 만드는 것은 그 속도를 높이는 것만큼이나 중요한 문제이다.
Error Correcting Code, ECC는 신뢰성 있는 메모리 구조를 만들기 위한 기술의 통칭이다. ECC는 다양한 방법과 기술들이 있는데, 오늘은 그중에서 Hamming이 제시한 방법에 대해서 알아볼 것이다.
이를 위해선 코드워드(Code word), 해밍 거리(Hamming Distance)에 대한 개념부터 잡고 가야한다.
코드 워드(Code Word)
이러한 오류에 대응하는 가장 기본적인 아이디어는 데이터에 대한 추가적인 여유분의 정보를 저장하는 것이다.
이때 데이터 비트 k개에, 그 데이터 비트를 보존할 여유 비트 r개를 추가하여 $n=k+r$ 비트의 새로운 비트열을코드워드(Code Word)라 말한다. k bits 데이터에 r개의 비트를 추가하여 n bits 크기의 코드워드를 만들었을 때, 이 규칙을 (n, k)라고 표시한다.
예컨대 현재 DDR5에서 가장 많이 사용되는 SEC 표준은 (136, 128) 표준인데, 이는 128 bits 데이터 비트에 8개의 추가 비트를 붙여서 하나의 코드워드를 만드는 것이다.
해밍 거리(Hamming Distance)
해밍 거리(Hamming Distance)는 같은 길이의 두 비트 패턴에서 같은 위치의 비트 중 값이 서로 다른 비트들의 개수로 정의한다.
$$
d_H (x, y) \coloneqq \text{popcount}(x\oplus y)
$$
예컨대 $x=0\underline{1}1\underline{0}11$과 $y=0\underline{0}1\underline{1}11$에서 해밍 거리 $d_H (x, y) = 2$이다. 같은 위치에서 다른 값을 가진 비트가 두 개 있기 때문이다.
또다른 예시로 $x=10\underline{1}1, y = 10\underline{0}1 \rightarrow d_H (x, y) = 1$이다.
에러 검출 능력 - 에러를 몇 개까지 검출하고 정정할 수 있는지 - 은 서로 다른 유효 코드 워드들(C) 사이의 최소 해밍 거리로 결정된다.
$$
d_{\min} = \min_{\substack{x,y\in C\\x\neq y}}{d_H (x,y)}
$$
SED
예를 들어, 한 시스템에서 유효 코드워드 $x_1$과 $x_2$ 사이 최소 해밍 거리 $d_{\min} = 2$라고 해보자. $y$는 내가 읽은 값으로, 한 개 비트에서 에러가 발생하였다. 그렇다면 $y$는 유효하지 않은 코드워드가 될 것이며, $y$와 $x_1$, $y$와 $x_2$ 사이 해밍 거리는 각각 1이다.
$$
\begin{align}d_{\min} = \nonumber \min_{\substack{x_1, x_2 \in C\\x_1 \neq x_2}}{d_H (x_1,x_2)} = 2 \\ \nonumber
d_H (x_1, y) = d_H(y, x_2) = 1
\end{align}
$$
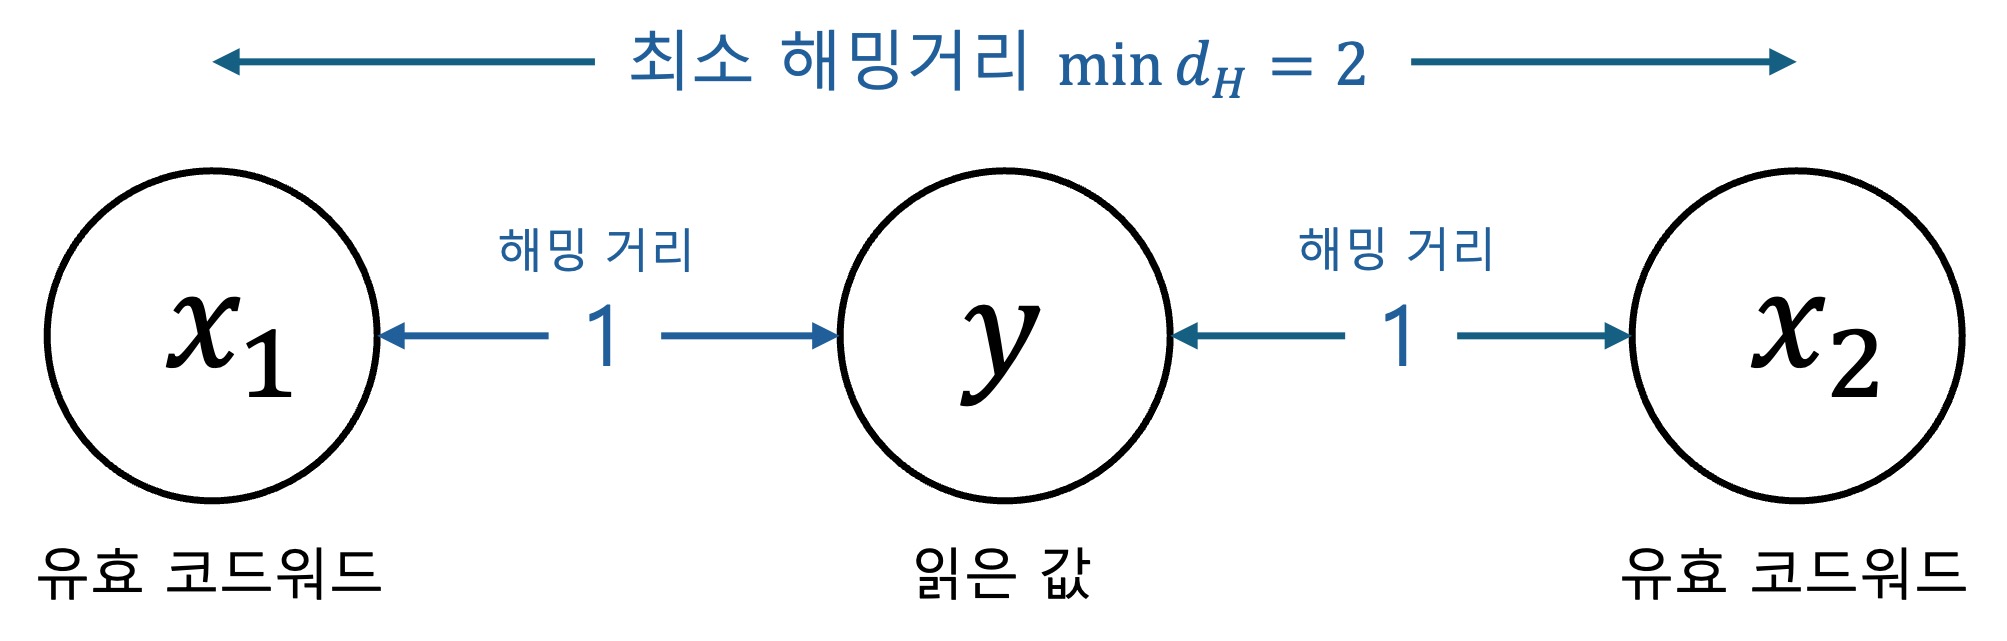
이때는 단일 비트 에러 검출을 할 수 있다. 단, 이때는 에러 발생 사실만을 알 수 있고, 정정까지는 불가능하다. $x_1$과 $x_2$ 중 어느 것으로 정정해야 할 지 알 수 없기 때문이다.
이 기술을 Single Error Detection, SED라고 한다.
SEC
만약 $d_{\min}=3$인 코드워드들 사이에서 한 비트 에러가 발생한다면, 이때는 에러 검출 뿐만 아니라 정정까지 가능하다.
$$
\begin{align}d_{\min} = \nonumber \min_{\substack{x_1, x_2 \in C\\x_1 \neq x_2}}{d_H (x_1,x_2)} = 3 \\ \nonumber
d_H (x_1, y) = 1 \\ \nonumber d_H(y, x_2) = 2
\end{align}
$$
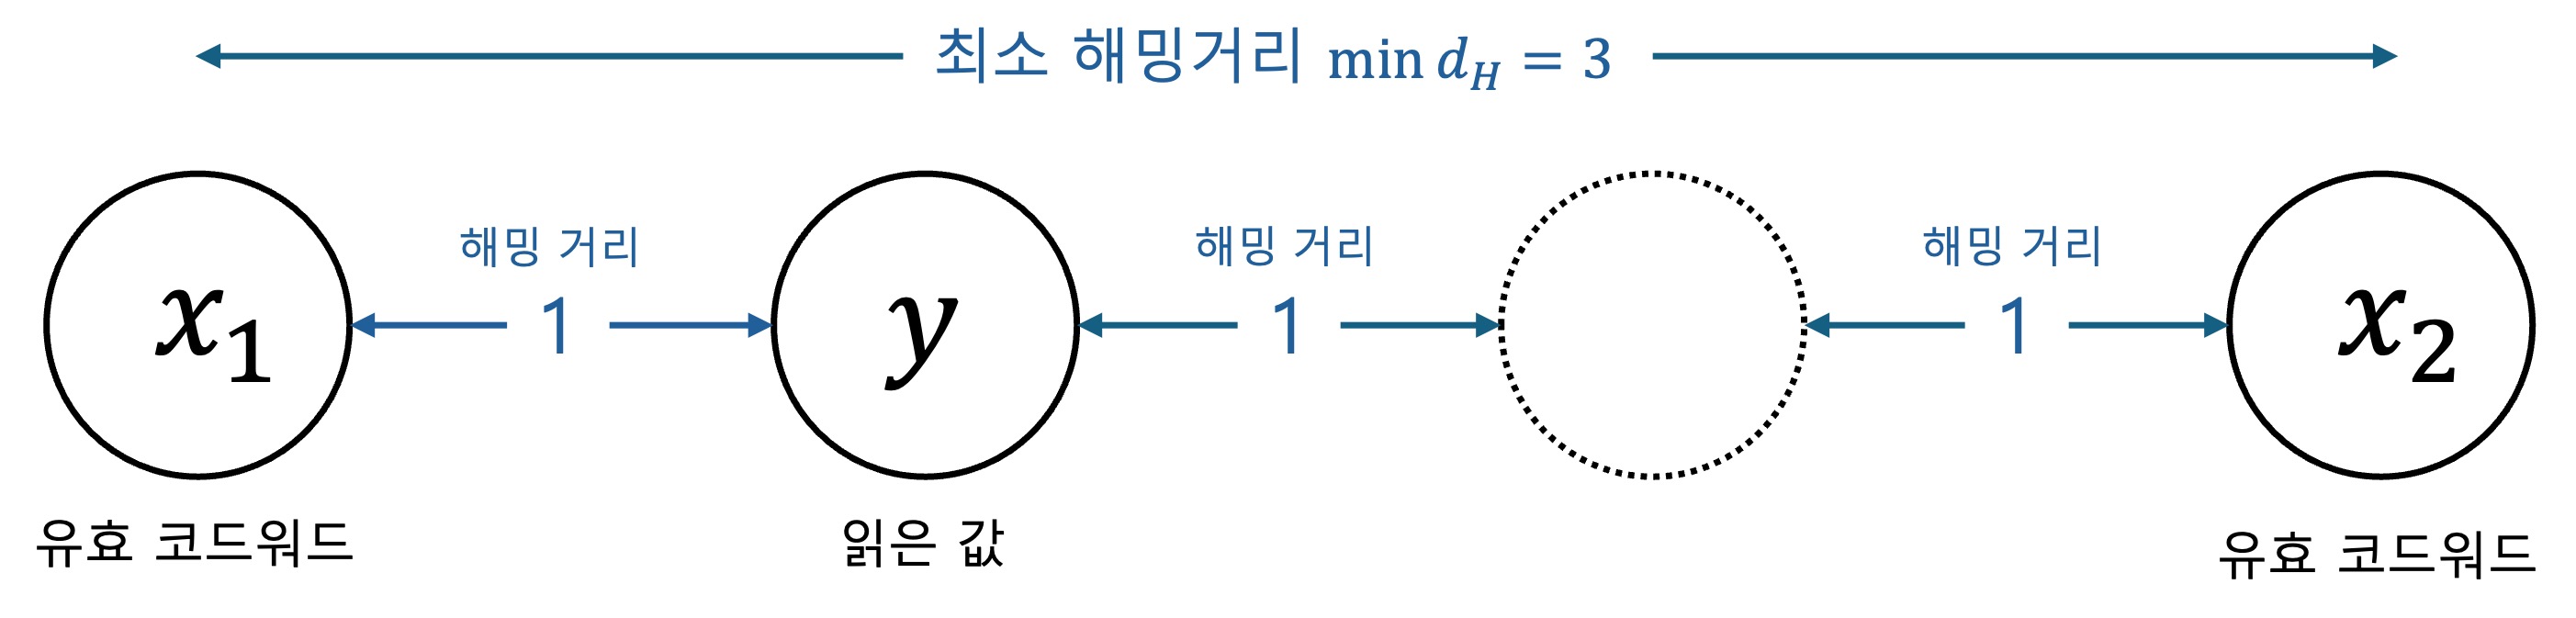
최소 해밍거리 $d_{\min}=3$이라면, 단일 비트 오류가 발생한 값 $y$에 대해서 $x_1$과 $x_2$중 조금 더 가까운 값으로 정정을 수행할 수 있다.

위 그림에서 $d_H (x_1, y) = 1<d_H(y, x_2) = 2$ 이므로 $x_1$으로 정정한다.
이 기술을 Single Error Correction, SEC라 한다.
SECDED
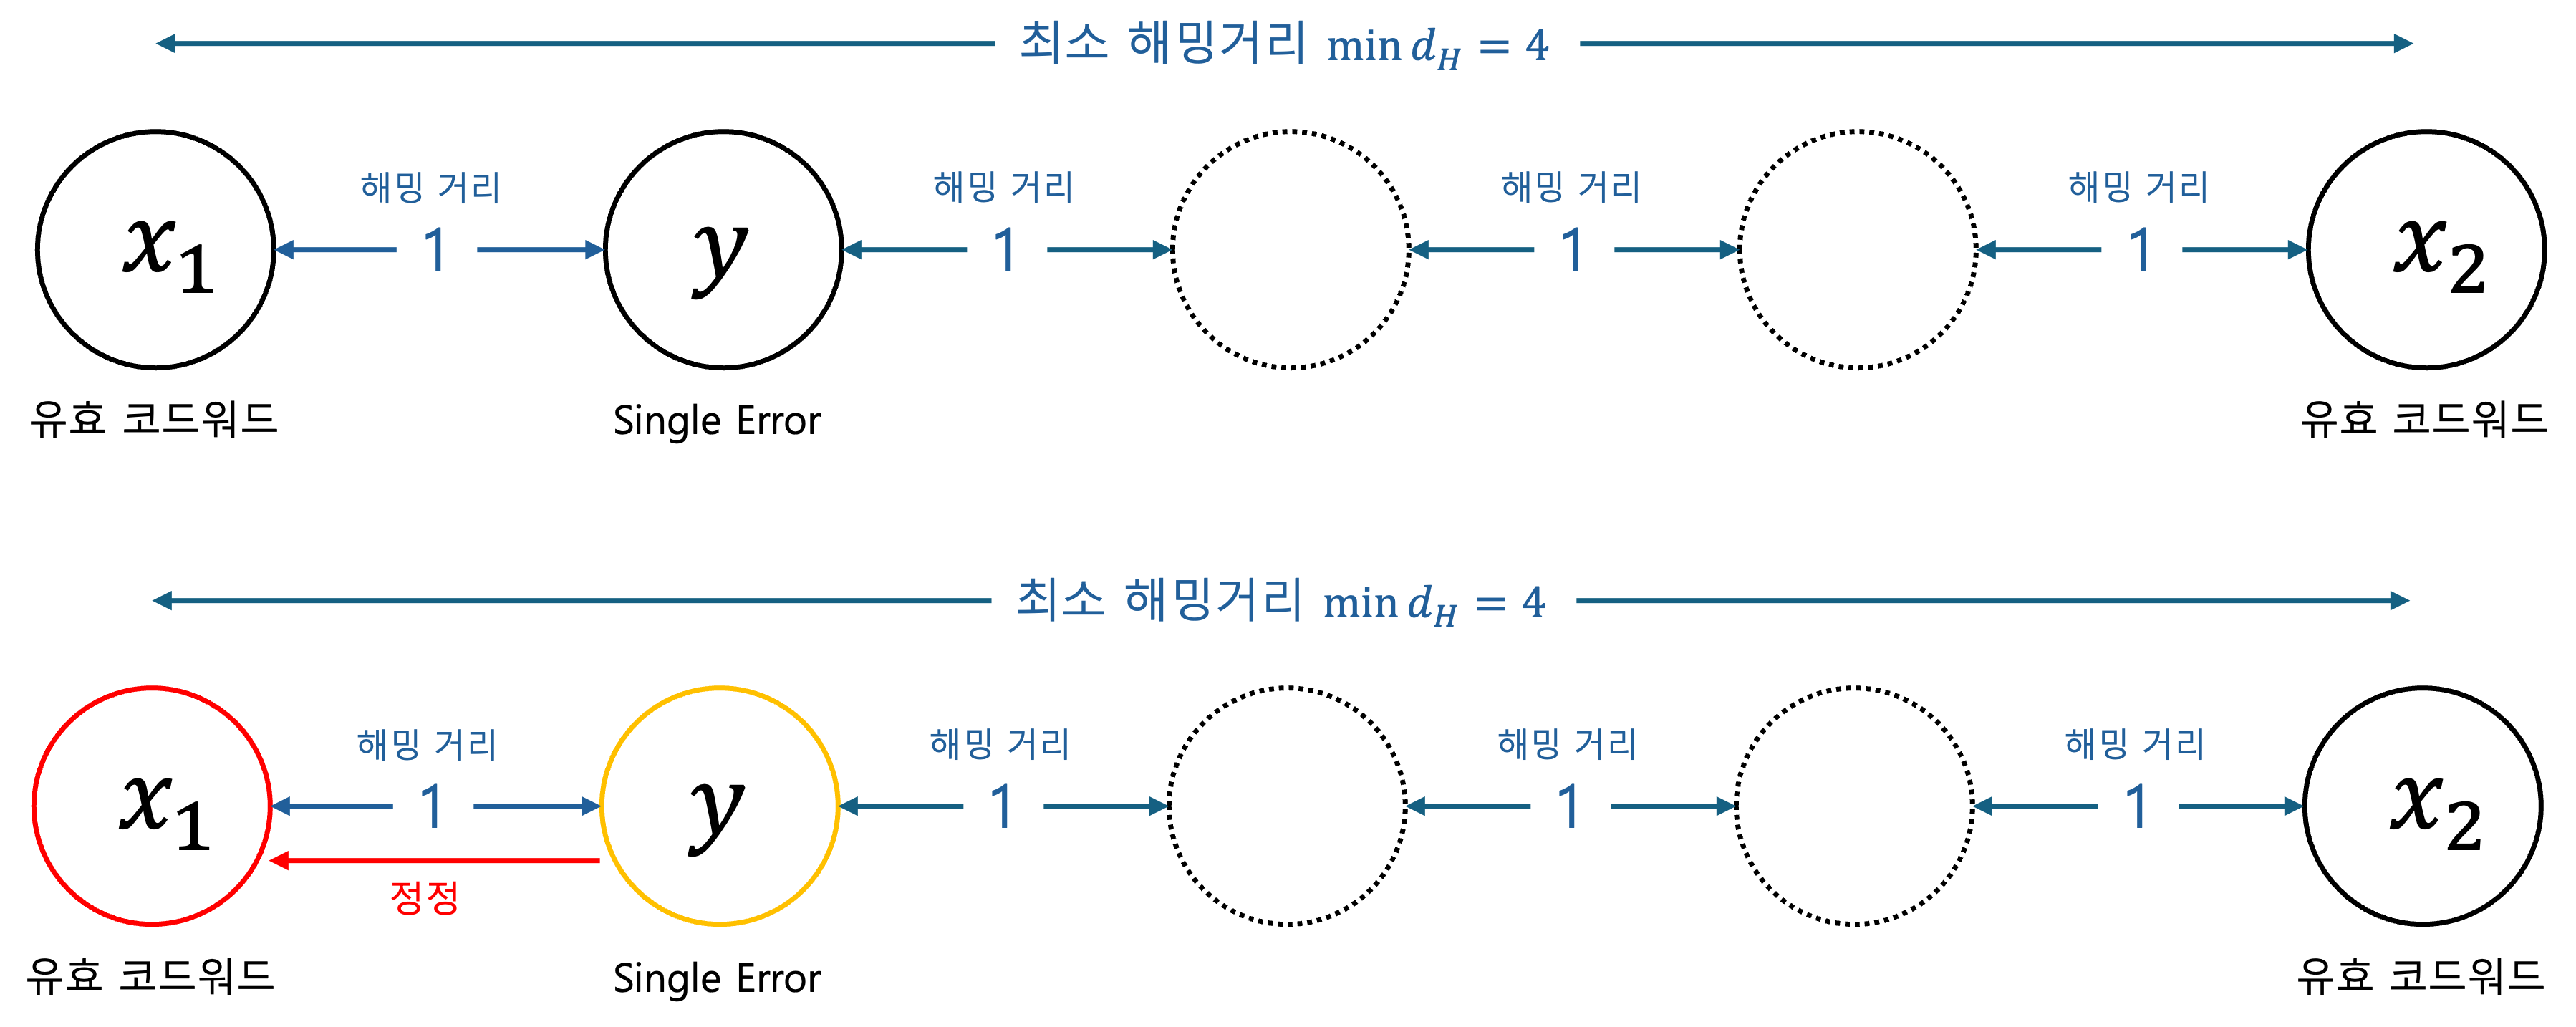
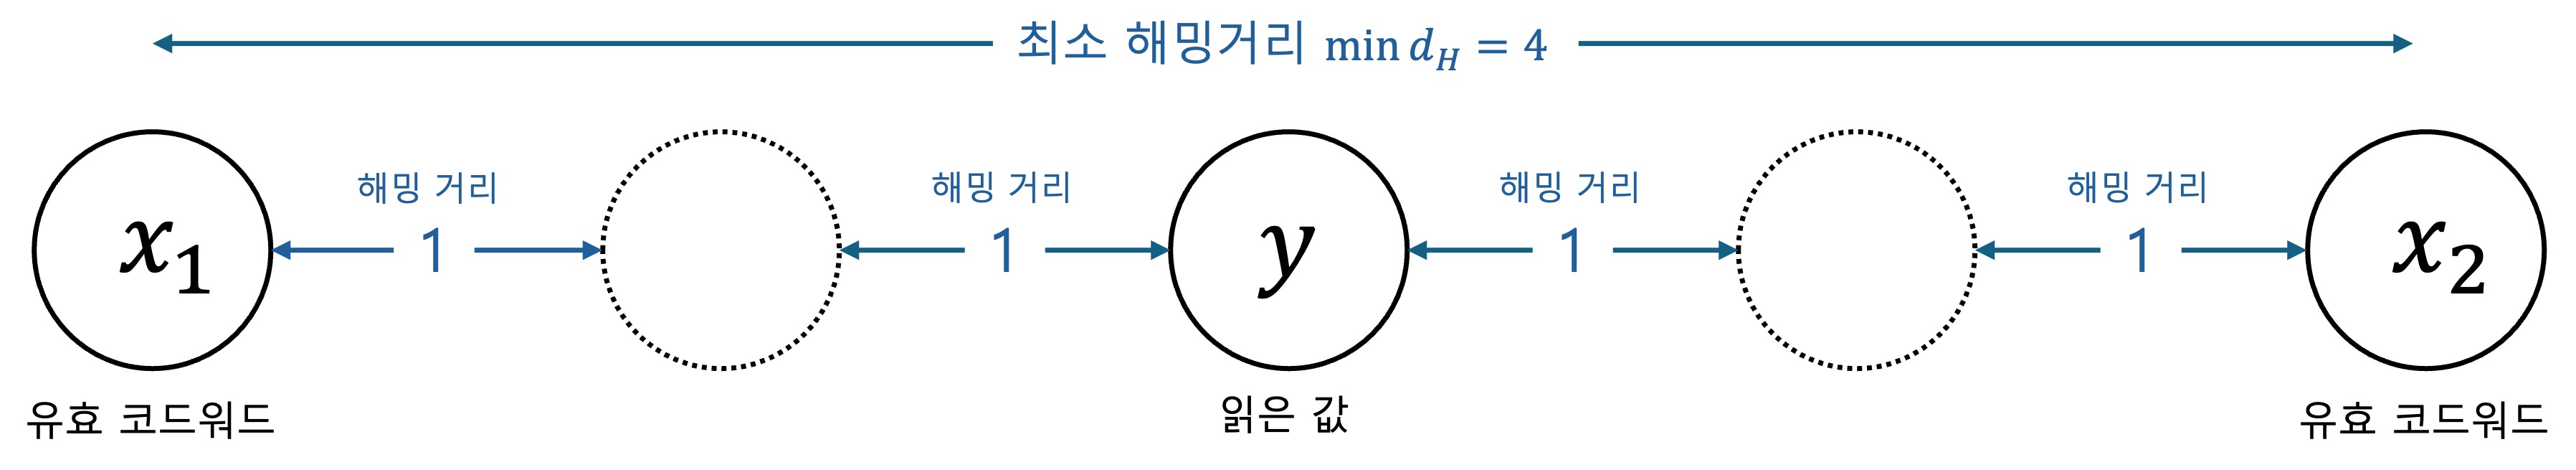
만약 $d_{\min}=4$라면 어떻게 될까?
\begin{align}d_{\min} = \nonumber \min_{\substack{x_1, x_2 \in C\\x_1 \neq x_2}}{d_H (x_1,x_2)} = 4 \\ \nonumber
d_H (x_1, y) = 1 \\ \nonumber d_H(y, x_2) = 3
\end{align}
위 상황에서 단일 비트 오류가 발생한 $y$에 대해서 Single Error Correction(단일 비트 오류 정정)이 가능한 것은 물론,
$$
\begin{align}d_{\min} = \nonumber \min_{\substack{x_1, x_2 \in C\\x_1 \neq x_2}}{d_H (x_1,x_2)} = 4 \\ \nonumber
d_H (x_1, y) = d_H(y, x_2) = 2
\end{align}
$$
이중비트오류가 발생한 $y$에 대해서 Double Error Detection(이중 비트 오류 탐지)까지 가능하다.
그러나 이때 $x_1$과 $x_2$로부터 해밍 거리가 같기 때문에 $y$의 값을 정정까지는 할 수 없다.
그렇기 때문에 이를 Single Error Correction & Double Error Detection, SECDED라고 한다.
이처럼 해밍거리가 늘어날수록 더 많은 오류를 검출하고, 정정할 수 있다.
그러나 더 많은 해밍거리를 확보하기 위해 더 많은 검사 비트를 추가해야 한다. 이는 전체 코드워드의 길이를 증가시켜 더 높은 비용을 발생시킨다.
사실 비트 하나를 추가한다는 게 그렇게 간단한 문제는 아닌게, DRAM은 내부적으로 버스로 연결되어 있어서, 하나의 비트를 추가하기 위해서는 그 비트를 위해서 추가적인 버스를 깔아야 하고, 그 버스 공간만큼 비트가 낭비될 수 있다.
이제 본격적으로 구현을 해보자.
Parity Code
오류를 검출하는 가장 보편적인 방법은 패리티 비트(Parity Bit)를 추가하는 것으로, ECC의 모든 개념은 패리티에서 출발한다.
짝수 패리티 시스템에서 패리티 코드는 워드 내의 1의 개수를 세어서 1의 개수가 홀수이면 1, 짝수이면 0의 값을 갖는다.
$$
p = d_1 \oplus d_2 \oplus \cdots \oplus d_k
$$
곧 {데이터 비트} + {패리티 비트} = {전체}에서 전체의 1의 개수를 짝수개로 만든다.
$$
d_1 \oplus d_2 \oplus \cdots \oplus d_k \oplus p = 0
$$
패리티 비트를 이용하면, 한 개의 비트가 오류났을 때 그 오류를 탐지할 수 있다(SED). 그러나 어디에서 오류가 발생했는지는 알 수 없다.
(9, 8) 코드워드에서 ${d_1, d_2, \cdots, d_8, p}$로 저장한다고 가정해보자.
예컨대 데이터 비트에 00011111을 저장했다면(이는 $31_{\text{ten}}$을 저장하는 것이다), 패리티 비트 $p=1$이 되어서 코드워드는 00011111 1 이 된다. 이것이 실제 메모리에 저장된 값이다.
이때 메모리 컨트롤러가 이 코드워드를 읽었는데, $d_1$이 오류가 나서 10011111 1 로 읽혔다고 해보자. 이때는 1의 개수가 홀수개가 되어서($d_1 \oplus d_2 \oplus \cdots \oplus d_k \oplus p = 1$) 단일 비트 오류가 났음을 검출할 수 있다. 그러나 어디에서 오류가 발생했는지는 알 수 없다.
한편 만약에 두 개의 비트에서 오류가 발생했을 경우, 그때에는 1의 개수가 다시 짝수개가 되어서 오류를 검출하지 못 한다.
Parity Code는 단일 비트 오류 검출(SED)에는 효과적이지만 정정(SEC)에는 실패한다. 이 이유는 Parity Code의 최소 해밍 거리는 2이기 때문이다.
📌 만약에 삼중 비트 오류(Triple Error)가 난다면, Parity Code는 다시 한 번 검출에 성공할 것이다. Parity Code는 홀수 개의 비트 오류에 대해서는 검출에 성공하고 짝수 개의 비트 오류에 대해서는 검출에 실패한다. 그러나 삼중 비트 오류는 이중 비트 오류에 비해 발생 확률이 훨씬 더 낮으므로, 일반적으로 Parity Code는 단일 에러 검출 코드로 간주한다.
📌 여기서는 짝수 패리티를 기준으로 설명하였다. 홀수 패리티는 전체 패리티 검사가 홀수가 되게끔 패리티 비트의 부호가 결정된다.
해밍 SEC Code
Parity Code의 한계를 극복하기 위해서, Richard Hamming은 단일 비트 오류를 정정(SEC)하는 코드를 고민하였다. 이를 위해선 최소 해밍 거리가 3인 코드를 고안해야 한다.
최소 해밍 거리가 3인 코드를 사상시키기 위해 Hamming은 Parity Code 여러 개를 조합하는 방식으로 이 문제를 해결했다. 이 공로로 Hamming은 1968년 컴퓨터과학 계의 노벨상이라 불리우는 튜링상을 수상했다.
이를 Hamming 에러 검출 코드(Hamming Error Correction Code, ECC)라 한다.
해밍 코드의 원리는, 검사 비트 묶음을 여러 개를 만들어서, 서로 다른 데이터 비트 위치에 대해서 검사를 참여하게 한다. 이를 미리 신드롬으로 매핑해둬서, 매핑된 값으로 어느 위치에 오류가 발생했는지를 바로 확인하는 기법이다.
인코딩
해밍 코드에서는, 번호가 2의 거듭제곱에 해당하는 모든 비트를 패리티 비트로 삼는다. 즉 위치가 1, 2, 4, 8, 16, $\ldots$ 인 위치의 비트가 곧 $p_1, p_2, p_3, p_4, p_5, \ldots$가 된다. 그리고 다른 비트 위치들을 전부 데이터 비트로 삼는다.
참고로 이 위치에 패리티 비트를 삼는 이유는 위치 비트를 기준으로 어떤 검사에 참여시킬 지를 결정하기 때문이다. 위치를 이진으로 표시할 시 001, 010, 100이 되면서 어느 위치를 검사에 참여시킬 지 기준이 명확해진다. 위치 비트를 $g$라 할 때, 예컨대 $g_{p_2}=(0,1,0)$에 대해서 $g_2=1$인 위치의 비트들만을 2번째 검사에 참여시킬 수 있다. 혹은 $g_{p_3} = (1,0,0)$이므로 $g_1=1$인 비트들만을 3번째 검사에 참여시킬 수 있다.
설명을 위해서 먼저 (7, 4)의 작은 예시를 들어보기로 하겠다. 데이터 비트 4 bits에, 3개의 검사 비트를 추가한 코드워드의 형태이다.
먼저 패리티 비트와 데이터 비트의 위치를 표로 정리하면 아래 표와 같다.
| 위치 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
| 위치(이진) | 001 | 010 | 011 | 100 | 101 | 110 | 111 |
| 비트 | $p_1$ | $p_2$ | $d_1$ | $p_3$ | $d_2$ | $d_3$ | $d_4$ |
이때 위치 비트를 $g$라 하자. 예컨대 여기서는 $g=(g_1 g_2 g_3)$이다.
이때 각 패리티 비트에 대해서 검사 그룹을 다음과 같이 지정한다.
| 검사 | 포함하는 위치 | 선택 기준 | 패리티 |
| 검사1 | 1, 3, 5, 7 | $g_3 = 1$ | $p_1 = d_1 \oplus d_2 \oplus d_4$ |
| 검사2 | 2, 3, 6, 7 | $g_2 = 1$ | $p_2 = d_1 \oplus d_3 \oplus d_4$ |
| 검사3 | 4, 5, 6, 7 | $g_1 = 1$ | $p_3 = d_2 \oplus d_3 \oplus d_4$ |
이렇게 검사식을 치밀하게 구성해놓으면, 모든 데이터 비트는 2개 이상의 서로 다른 조합의 검사식에 참여한다. 따라서 어떤 데이터 비트가 바뀌더라도 그에 대응하는 검사식의 조합을 알 수 있다.
예를 들어 6번 위치에 있는 비트($d_3$)는 $110_{2}$이므로, 검사2와 검사3에만 참여한다($g_1 = 1, g_2=1$ 이므로). 그렇다면 6번 비트가 잘못 읽혔을 경우, 검사2와 검사3만 실패할 것이다.
3번 비트($d_1$)는 $011_{2}$이므로, 검사1과 검사2에만 참여한다($g_2 = 1, g_3=1$이므로). 3번 비트가 잘못 읽혔을 경우, 검사1과 검사2만 실패할 것이다.
만약 우리가 저장하려는 데이터가 d=1011이라 해보자. ${d_1, d_2, d_3, d_4}= {1, 0, 1, 1}$에서
$$
\begin{align}
\nonumber p_1 = d_1 \oplus d_2 \oplus d_4 = 0 \\
\nonumber p_2 = d_1 \oplus d_3 \oplus d_4 = 1 \\
\nonumber p_3 = d_2 \oplus d_3 \oplus d_4 = 0
\end{align}
$$
이 된다. 따라서 코드워드를 $c$라 할 때
$$
c = {0,1,1,0,0,1,1}
$$
이 된다. 0110011이 실제로 메모리에 저장되는 값이다.
디코딩
이제 이 데이터를 읽는 과정에서, 6번째 비트가 1에서 0으로 잘못 읽었다고 해보자.
실제 값: 0110011
읽은 값: 0110001
$$
y = {0,1,1,0,0,\underline{0},1}
$$
$y$에 대해서 패리티 검사를 수행해보자.
$$
\begin{align}
\nonumber s_1 = y_1 \oplus y_3 \oplus y_5 \oplus y_7 = 0 \\
\nonumber s_2 = y_2 \oplus y_3 \oplus y_6 \oplus y_7 = 1 \\
\nonumber s_3 = y_4 \oplus y_5 \oplus y_6 \oplus y_7 = 1
\end{align}
$$
이때 이 결과들의 묶음 $s = (s_3 s_2s_1)_{2}$을 신드롬이라 한다.
$$
s = (s_3 s_2s_1)_{2} = 110_{2} = 6_{\text{ten}}
$$
에서 바로 6번 비트가 오류가 났음을 알 수 있고, 이를 정정하여 원래의 코드워드인 0110011을 복구할 수 있다.
이때 복구한 코드워드를 $c$라 하면, 패리티 부호를 제외하고 데이터 비트 $(c_3c_5c_6c_7)$만 읽으면 1011이 나온다.
해밍 검사 행렬
검사식을 일반화해보면, 검사 행렬 $H$를 구할 수 있다. 위 예제에서 위치를 나타내는 $g$를 열벡터로 두고, 검사식 $s$를 행벡터로 두면
$$
H=
\begin{bmatrix}
1&0&1&0&1&0&1\\
0&1&1&0&0&1&1\\
0&0&0&1&1&1&1
\end{bmatrix}
$$
가 된다.
유효한 코드워드에 경우 검사 행렬을 통과해야 하므로 $Hc =0$이 된다.
코드워드 0110011 을 열벡터 $c$로 둔다면
$$
\begin{align}\nonumber
Hc =\begin{bmatrix}
1&0&1&0&1&0&1\\
0&1&1&0&0&1&1\\
0&0&0&1&1&1&1
\end{bmatrix}
\begin{bmatrix}
0\\
1\\
1\\
0\\
0\\
1\\
1\\
\end{bmatrix} \\ \nonumber
=
\begin{bmatrix}
0\\
0\\
0
\end{bmatrix}
\end{align}
$$
한편 읽었을 때 오류가 난 비트열을 $y$라 할 때 신드롬 $s=Hy$이다.
(7, 4) 예시에서 신드롬은 $
s = Hy =
\begin{bmatrix}
s_1\\
s_2\\
s_3
\end{bmatrix}
$이다.
오류가 난 비트열 0110001을 열벡터 $y$로 둔다면
$$
\begin{align}\nonumber
Hc &=\begin{bmatrix}
1&0&1&0&1&0&1\\
0&1&1&0&0&1&1\\
0&0&0&1&1&1&1
\end{bmatrix}
\begin{bmatrix}
0\\
1\\
1\\
0\\
0\\
\underline{0}\\
1\\
\end{bmatrix} \\ \nonumber
&=
\begin{bmatrix}
0 \oplus 1 \oplus 0 \oplus 1 \\
1 \oplus 1 \oplus 0 \oplus 1 \\
0 \oplus 0 \oplus 0 \oplus 1
\end{bmatrix} \\ \nonumber
&=
\begin{bmatrix}
0 \\
1 \\
1
\end{bmatrix}
\end{align}
$$
이는 곧 6번째 비트열 $H_6$와 같다. 따라서 6번째 비트가 오류가 났음을 알 수 있다.
오류가 난 위치를 1, 나머지를 0으로 표시하는 오류 벡터 $e$에 대해서, 읽은 비트열 $y = c\oplus e$에서 $s = H_y = H(c\oplus e) = Hc \oplus He = He$이다.
여기서는 6번째 비트가 뒤집혔으므로 $e_6=1$이고 나머지는 0이다.
$$
y=c\oplus e
=
\begin{bmatrix}
0\\1\\1\\0\\0\\1\\1
\end{bmatrix}
\oplus
\begin{bmatrix}
0\\0\\0\\0\\0\\1\\0
\end{bmatrix}
=
\begin{bmatrix}
0\\1\\1\\0\\0\\0\\1
\end{bmatrix}
$$
로 $y$에 대해서 생각을 할 수도 있고,
$$
\begin{align} \nonumber
He &=
\begin{bmatrix}
1&0&1&0&1&0&1\\
0&1&1&0&0&1&1\\
0&0&0&1&1&1&1
\end{bmatrix}
\begin{bmatrix}
0\\0\\0\\0\\0\\1\\0
\end{bmatrix} \\ \nonumber
&=
\begin{bmatrix}
0\\1 \\1
\end{bmatrix}
\end{align}
$$
로 생각을 해도 된다. 결과는 같다.
예시 - (12, 8)
살짝 복잡하지만, (12, 8) 코드워드로 크기를 확장해보자.
여기선 패리티 부호가 4개이므로, 검사 행렬 $H$는 $4\times12$ 크기의 행렬이다. 이때 패리티 열은 $H_1, H_2, H_4, H_8$으로 굵은 글씨로 표기하였다.
$$
H=
\begin{bmatrix}
\textbf{1}&\textbf{0}&1&\textbf{0}&1&0&1&\textbf{0}&1&0&1&0\\
\textbf{0}&\textbf{1}&1&\textbf{0}&0&1&1&\textbf{0}&0&1&1&0\\
\textbf{0}&\textbf{0}&0&\textbf{1}&1&1&1&\textbf{0}&0&0&0&1\\
\textbf{0}&\textbf{0}&0&\textbf{0}&0&0&0&\textbf{1}&1&1&1&1\\
\end{bmatrix}
$$
인코딩
1바이트 데이터 값을 10011010이라 한다면, 먼저 이 데이터의 코드워드를 구해보자.
| 검사 | 포함하는 위치 | 선택 기준 | 패리티 |
| 검사1 | 1, 3, 5, 7, 9, 11 | $g_4 = 1$ | $p_1 = d_1 \oplus d_2 \oplus d_4 \oplus d_5 \oplus d_7$ |
| 검사2 | 2, 3, 6, 7, 10, 11 | $g_3 = 1$ | $p_2 = d_1 \oplus d_3 \oplus d_4 \oplus d_6 \oplus d_7$ |
| 검사3 | 4, 5, 6, 7, 12 | $g_2 = 1$ | $p_3 = d_2 \oplus d_3 \oplus d_4 \oplus d_8$ |
| 검사4 | 8, 9, 10, 11, 12 | $g_1 = 1$ | $p_4 = d_5 \oplus d_6 \oplus d_7 \oplus d_8$ |
$$
\begin{align}
\nonumber p_1 = d_1 \oplus d_2 \oplus d_4 \oplus d_5 \oplus d_7 = 0 \\
\nonumber p_2 = d_1 \oplus d_3 \oplus d_4 \oplus d_6 \oplus d_7 = 1 \\
\nonumber p_3 = d_2 \oplus d_3 \oplus d_4 \oplus d_8 = 1 \\ \nonumber
p_4 = d_5 \oplus d_6 \oplus d_7 \oplus d_8 = 0
\end{align}
$$
따라서 최종 코드워드는 011100101010 이 된다(패리티 검사 비트를 굵은 색 표시하였다).
디코딩
만약 읽은 값이 01110 01011 10 이라 해보자.
$$
\begin{align} \nonumber
Hy &= \begin{bmatrix}
1&0&1&0&1&0&1&0&1&\textbf{0}&1&0\\
0&1&1&0&0&1&1&0&0&\textbf{1}&1&0\\
0&0&0&1&1&1&1&0&0&\textbf{0}&0&1\\
0&0&0&0&0&0&0&1&1&\textbf{1}&1&1\\
\end{bmatrix}
\begin{bmatrix}
0\\1\\1\\1\\0\\0\\1\\0\\1\\1\\1\\0
\end{bmatrix}
\\ \nonumber
&=
\begin{bmatrix}
0\\1\\0\\1
\end{bmatrix}\\ \nonumber
&= H_{10}
\end{align}
$$
이므로 011100101110 은 10번째 비트가 잘못되었음을 알 수 있고, 10번째 비트를 반전시키면 유효한 코드워드 01110 01010 10이 된다. 패리티 비트를 제외하면 온전한 데이터 1001 1010을 추출할 수 있는데, 이는 처음에 우리가 설정한 값과 일치한다.
그런데 행렬을 다시 한 번 살펴보면, 특이점을 발견할 수 있다.
$$
H=
\begin{bmatrix}
\textbf{1}&\textbf{0}&1&\textbf{0}&1&0&1&\textbf{0}&1&0&1&0\\
\textbf{0}&\textbf{1}&1&\textbf{0}&0&1&1&\textbf{0}&0&1&1&0\\
\textbf{0}&\textbf{0}&0&\textbf{1}&1&1&1&\textbf{0}&0&0&0&1\\
\textbf{0}&\textbf{0}&0&\textbf{0}&0&0&0&\textbf{1}&1&1&1&1\\
\end{bmatrix}
$$
신드롬을 보면, 0001, 0010, $\cdots$, 1100 까지만 사용하고 있다. 1101, 1110, 1111 은 신드롬으로 매핑되지 않는다.
코드워드의 크기가 커질수록 사용하지 않는 신드롬은 대체로 늘어난다. (136, 128) 표준같은 경우 119개의 신드롬이 매핑되지 않은 채 남는다. 이때 신드롬은 굳이 순서대로 0001, 0010, $\cdots$ 이런 식으로 매핑할 필요는 없다. 사실 어떠한 열벡터를 선택해서 매핑할 것이냐는 메모리 제조사마다 고민하는 중요한 문제이며, 이는 다음 글에서 다룰 Aliasing이라는 문제점을 해결하기 위한 열쇠가 되기도 한다.
필요한 비트의 개수
우리는 (7, 4), (12, 8)의 예시를 보았다. 그렇다면 데이터 비트가 늘어날 수록, 저장해야 하는 패리티 비트의 수는 얼마나 늘어나야 하는가?
SEC 코드에서 데이터 비트 수 $d$와 패리티 비트 수 $p$가 있다고 가정할 때 $2^p \ge p+d+1$ 비트 관계를 만족시켜야 한다. 곧 $p\ge \lg (p+d+1)$ 을 만족시켜야 한다.
예컨대 4비트 데이터면 $d=4$이고 $2^p \ge p+4+1 = p+5$이므로 $p=3$이다. 데이터 비트 별 필요한 패리티 비트 수를 정리하면 아래 표와 같다.
| 데이터 비트 수($d$) | 조건 | 패리티 비트 수($p$) |
| 4 | $2^p \ge p+4+1$ | 3 |
| 8 | $2^p \ge p+8+1$ | 4 |
| 16 | $2^p \ge p+16+1$ | 5 |
| 32 | $2^p \ge p+32+1$ | 6 |
| 64 | $2^p \ge p+64+1$ | 7 |
| 128 | $2^p \ge p+128+1$ | 8 |
해밍 SECDED Code
Hamming은 여기서 한 발 더 나아가서, 단일 비트 오류를 정정할 뿐만 아니라 이중 비트 오류를 검출까지 할 수 있는 = 즉 최소 해밍 거리가 4에 사상되는 코드워드를 원했다.
SEC 코드에서 한 비트만 더 사용하면 최소 해밍 거리를 4로 사상시킬 수 있다. 이를 통해서 SECDED - 단일 비트 오류를 정정하고 이중 비트 에러를 검출하는 코드를 만들 수 있다. 추가되는 한 비트는 전체 코드 워드에 대한 패리티 비트이다.
인코딩
| 위치 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| 비트 | $p_1$ | $p_2$ | $d_1$ | $p_3$ | $d_2$ | $d_3$ | $d_4$ | $\mathbf{p_0}$ |
SECDED의 기본 아이디어는 전체 코드워드에 대한 패리티 $p_0$ 비트를 하나 더 추가하는 것이다.
아까 (7, 4) 예시로 돌아가보자. 0110011 코드워드에 대한 전체 패리티 비트를 추가해보자.
$$
p_0 = c_1 \oplus c_2 \oplus \cdots \oplus c_7 = 0
$$
따라서 새로운 (8, 4) SECDED 코드워드에서는 01100110 을 저장하게 된다.
디코딩
디코딩 과정은 기존 SEC에서의 7비트로 신드롬 $s$를 계산하고, 전체 그룹에 대한 패리티를 하나 더 계산하면 된다.
읽은 값이 $(y_1, y_2, \ldots, y_7, y_{p_0})$라 하면, 7비트로 계산된 신드롬 $s = Hy$는 이전과 계산이 똑같다.
$$
s= Hy = H\begin{bmatrix}
y_1\\
y_2\\
\vdots \\
y_7
\end{bmatrix}
$$
그리고 신드롬과 별개로 전체 코드워드에 대한 패리티 검사를 다시 한 번 수행한다. 이를 $P$에 저장한다고 하자.
$$
P = y_1 \oplus y_2 \oplus \cdots \oplus y_7 \oplus y_{p_0}
$$
만약 $P=1$이면 짝수 패리티가 깨진 상황이다.
이때에 크게 네 가지 경우의 수가 발생한다.
| 구분 | $P = 0$ | $P=1$ |
| $s=0$ | No Error | Double Error 발생 |
| $s\ne 0$ | $p_0$ 비트에 단일 에러 발생 | Single Error 발생 |
- $P=0, s = 0$인 경우 에러가 없는 상태다.
- $P=0, s\ne 0$인 경우 $c_{p_0}$에 단일 비트 에러가 발생한 경우이다. 이때는 $c_{p_0}$를 정정한다($p_0$를 뒤집는다).
- $P=1, s=0$인 경우 이중 비트 에러가 발생한 상태다. 이때는 정정하지 않고 검출 여부만 상위 레이어에 알려준다.
- $P=1, s \ne 0$인 경우 단일 비트 에러가 발생한 상태다. 이때는 바로 정정까지 이루어진다.
한 가지 주의할 점은, SECDED 코드워드에서 이중 비트 에러를 검출할 경우, 이를 정정하는 문제는 여기서 고려할 문제는 아니다. 이는 상위 레이어에서 처리할 문제로, SECDED는 그저 검출 여부만 알려줄 뿐이다.
본 글에서는 신뢰성 있는 메모리 구조를 만드는 방법을 소개하며 Hamming ECC의 원리에 대해서 소개하였다.
이러한 ECC 장치는 여러 레이어로 위치해있는데, 최신의 DDR5 표준에서는 On-die ECC가 표준화되면서 메모리 칩 자체에 ECC 장치가 추가되었다. On-die ECC에 보통 SEC가 들어간다.
한편 오늘날에 서버용 메모리에는 SECDED가 메모리 컨트롤러에 표준처럼 사용된다. 이때 메모리 컨트롤러에 들어가는 ECC는 Off-die ECC, 혹은 External ECC 등으로 표현하며 On-die ECC 대비 다른 레이어로 구분하기도 한다.
다음 글에서는 SEC ECC에서 발생하는 Aliasing Problem에 대해서 소개하고, 이를 최소화시키기 위한 Minimal Aliasing SEC Code에 대해서 알아보겠다.
📚 참고 문헌
- David A. Patterson, John L. Hennessy. (2022). 컴퓨터 구조 및 설계: RISC-V Edition (박명순·김병기·하순회·장훈 옮김; 제2판). 한티미디어.
- Pae, S. I., Kozhikkottu, V., Somasekar, D., Wu, W., Ramasubramanian, S. G., Dadual, M., ... & Kwon, K. W. (2021). Minimal aliasing single-error-correction codes for dram reliability improvement. IEEE Access, 9, 29862-29869.
- Error Correction and the Hamming Code