
컴퓨터 공학에서 정보의 최소 단위는 0과 1로 이루어진 비트(bit)이다. 컴퓨터가 어떠한 정보를 저장한다는 건, 내부적으로는 0과 1로 이루어진 비트들의 집합을 순서와 규칙에 맡게 저장 장치에 저장한다는 것이고, 이를 위한 기술을 메모리 기술이라 한다.
사실 메모리 기술에는 무수히 많은 기술과 방법이 있다. 휘발성 메모리인 SRAM, DRAM 뿐만 아니라, 비휘발성 메모리 중에서는 낸드 플래시, 물리 디스크에 정보를 저장하는 하드디스크·CD·DVD 혹은 자기 테이프를 통해 저장하는 카세트 테이프 등도 모두 메모리 기술의 일종이다.
정보를 저장한다는 것은 세부적으로 비트를 저장하는 것이라면, 비트를 저장한다는 것은 또 어떻게 구현하는가?
물리 디스크에 실제 자기적 성질을 이용해서 물리적으로 홈을 파고, 이 홈에 레이저를 쏴서 반사되는 빛의 양을 바탕으로 0과 1을 결정하는 방법이 있다. 회로 상에서는, 전압과 전하를 이용해서 저장한다.
SRAM
Inverter를 이용해 저장하기

사실 아주 간단한 논리 회로만으로도 1비트를 저장하는 건 회로를 구현할 수 있는데, 두 개의 inverter만 있어도 1개 비트를 안정적으로 유지할 수 있다. 전원이 안정적으로 공급된다면, 위쪽 input에 1을 공급하면 output으로 0이 나오고, 이 output이 다시 또 아래쪽 inverter로 들어가서 1이 나오면서 시계 방향으로 도는 피드백 구조가 완성된다. 이 효과로 값이 안정적으로 유지된다. 이때 1을 공급한다는 건 정확히 말하면 높은 전압을 가한다는 말과 같다.
NOTE: 여기서 주의해야 할 건 전원을 공급하는 것과 전압을 높게 주는 것은 서로 다른 이야기이다. 1을 가한다는 건 전압을 가한다는 의미이고, 전류를 공급하는 건 물줄기를 흐르게 하는 것과 같다. 전류를 공급하는 게 1을 공급한다는 의미는 아니다. 전원이 없으면 그냥 데이터가 휘발될 뿐이다.
한 쌍의 인버터가 바로 SRAM의 저장 원리이며, 하나의 셀을 이룬다. 가장 간단하면서도 기본이 되는 저장원리다.
사실 그래서 저장만 따진다면 굉장히 간단한 문제인데, 다만 실제 우리가 원하는 메모리 기술을 구현하기 위해서는 몇 가지가 더 필요하다.
메모리를 만들기 위해서는 세 가지 기능을 충족시켜야 하는데,
- 일단 0인지 1인지를 쓸 줄 알아야 하고(Write)
- 이걸 유지해야 하며(Maintain)
- 쓴 값을 읽을 줄 알아야 한다(Read)
NOTE: 참고로 SRAM과 후술할 DRAM과의 차이는 2번 유지하는 방법에서 발생한다.
읽기와 쓰기 기능을 만들어보자.
MOS 트랜지스터
여기서 잠깐 주제를 돌려서, 논리회로 시간에 배운 MOSFET에 대해서 간단히 다시 짚고 넘어가자.
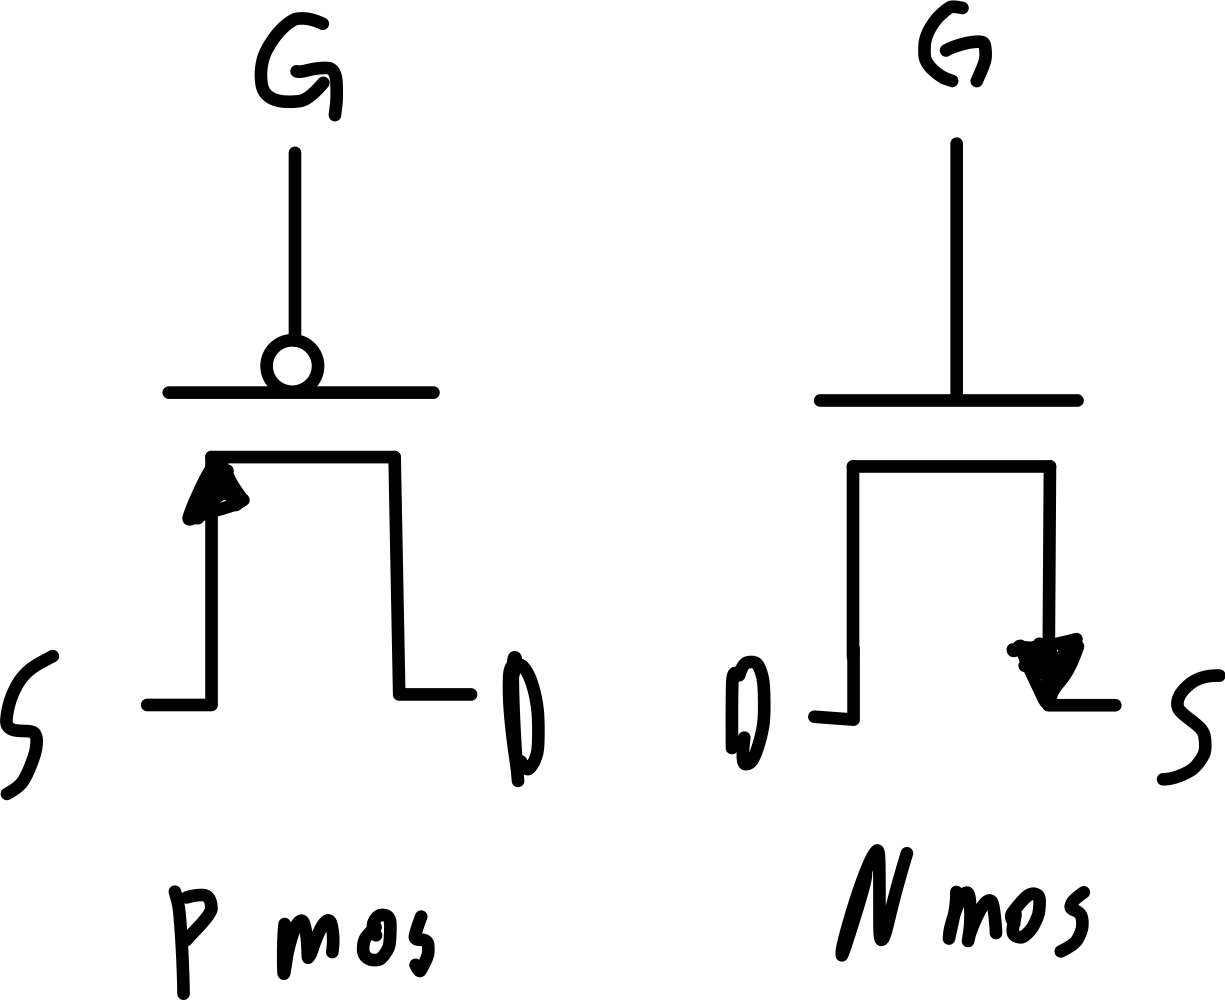
이렇게 생긴 두 트랜지스터가 있다. 게이트(G), 소스(S), 드레인(D)로 구성된 MOSFET이란 소자다.
이들의 역할은 스위치 작용으로써, G의 연결 신호에 따라 전류가 흐를 지 안 흐를 지를 결정하는 트랜지스터다. 단순하게 PMOS는 G = 0일 때 연결되고, NMOS는 G = 1일 때 연결된다.
정확히는 게이트와 소스 사이 전압 차이가 더 중요한데, G의 전압이 S의 전압보다 충분히 낮을 때 PMOS가 연결되고, NMOS의 경우 반대로 G의 전압이 S의 전압보다 충분히 높을 때 연결된다. NMOS의 임계 전압을 $V_{TN}$, PMOS의 임계 전압을 $\lvert V_{TP}\rvert$라 하고, 각 게이트와 소스와의 차이를 $V_{GS}=V_{G} - V_{S}$, $V_{SG} = V_{S}-V_{G}$ 라 할 때
- N mos: $V_{GS} =V_{G}-V_{S} > V_{TN}$
- P mos: $V_{SG}= V_{S}-V_{G} > V_{TP}$
일 때 연결된다. 여기서 연결된다는 말은, NMOS의 경우 노드를 낮은 전압 쪽으로 흐르게 하고, PMOS의 경우 노드를 높은 전압 쪽으로 흐르게 하는 효과를 가진다.
전압의 변화
이 글에서 편의상 ‘당겨진다’, ‘흐른다’같은 표현을 계속해서 사용할 건데, 이 의미를 정확하게 짚고 넘어가보자.
위에서 MOSFET은 노드를 특정 방향으로 흐르게 하는 효과를 준다고 하였는데, 이는 단순히 표현하여 노드의 전압을 접지 전압과 가까워지도록 만든다.
| $I_{\text{input}}$ | 노드 전압 | 노드 효과 |
| 1 | 0 → 1 (올라감) | 충전 |
| 0 | 1 → 0 (내려감) | 방전 |
노드의 정전 용량을 C라고 할 때
$$
C\cfrac{dV}{dt}=I_{\text{input}}-I_{\text{output}}
$$
관계가 성립하기에, 들어오고 나가는 전류의 양에 따라서 노드의 V값이 바뀐다. $I_{\text{input}}$이 크고 $I_{\text{output}}$이 작으면 노드를 충전시키고, 크다면 노드를 방전시켜서 V를 변화시킨다.
다시 말해서 NMOS는 전압이 높은 곳에서 낮은 곳으로 흐르며, 노드를 0으로 방전시킬 지 1로 충전시킬 지를 결정한다.
CMOS Inverter
NOT 게이트는 NMOS와 PMOS를 조합해서 만들 수 있다. 이를 CMOS inverter라고 한다. 즉 CMOS inverter는 두 개의 트랜지스터 조합으로 만들어진다.
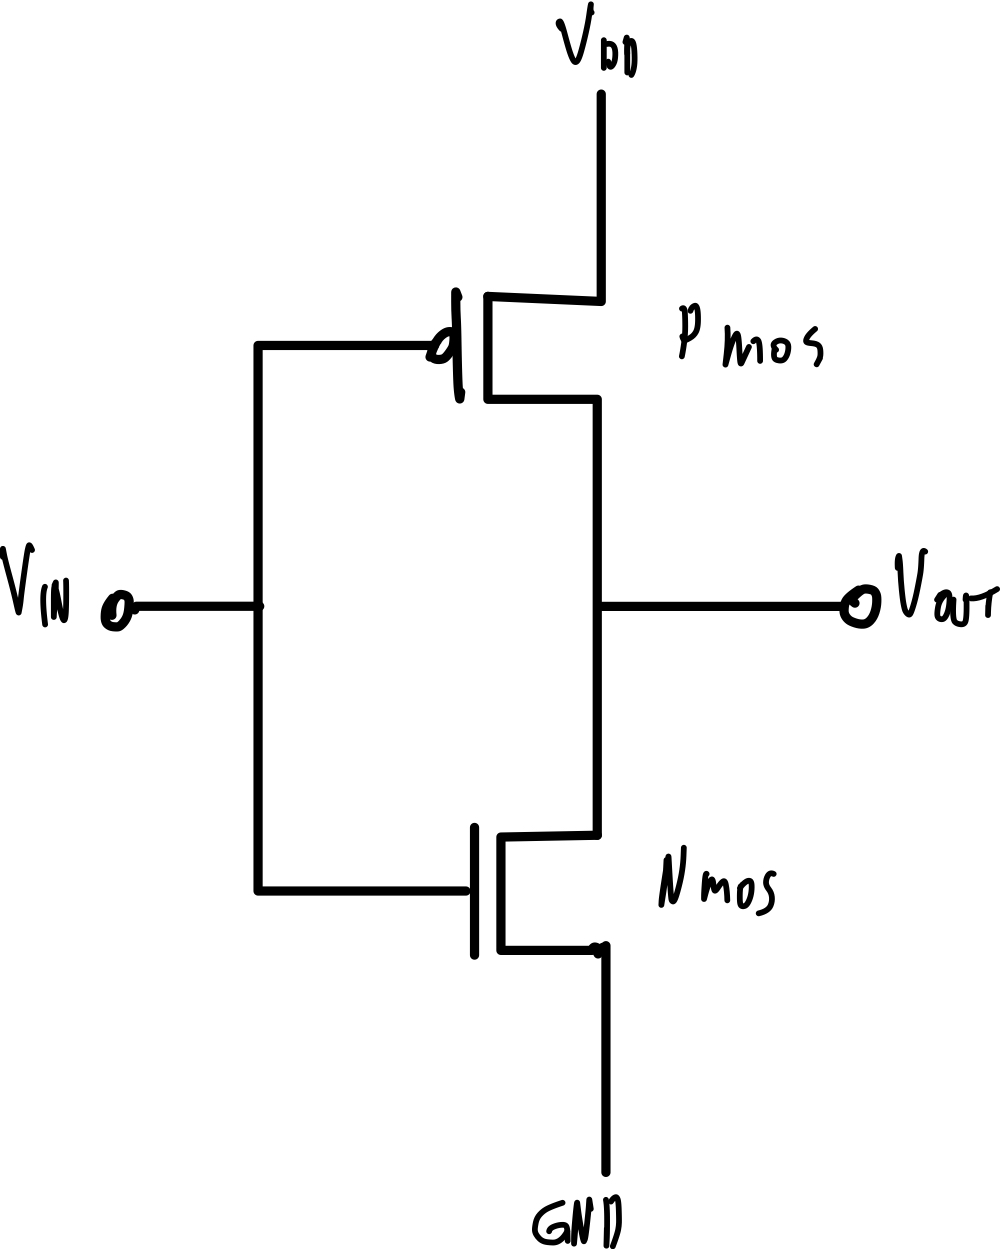
회로를 잘 따라가보면, $V_{\text{IN}}=0$일 때 PMOS가 켜지고, NMOS가 꺼진다. 그러므로 $V_{\text{DD}}$에서 흘러나온 출력이 $V_{\text{OUT}}$으로 나가서 1이 나온다.
반대로 $V_{\text{IN}}=1$일 때는 PMOS가 꺼지고 NMOS가 켜지므로, 출력은 GND(그라운드) 쪽으로 흐르면서 $V_{\text{OUT}}=0$이 된다.
| $V_{\text{IN}}$ | PMOS | NMOS | $V_{\text{OUT}}$ |
| 0 | ON | OFF | 1 |
| 1 | OFF | ON | 0 |
이렇게 해서 간단하게 CMOS Inverter를 구현할 수 있다. 기억해야 할 점은 NOT GATE에는 2개의 트랜지스터가 들어간다고만 기억해도 된다.
읽기와 쓰기
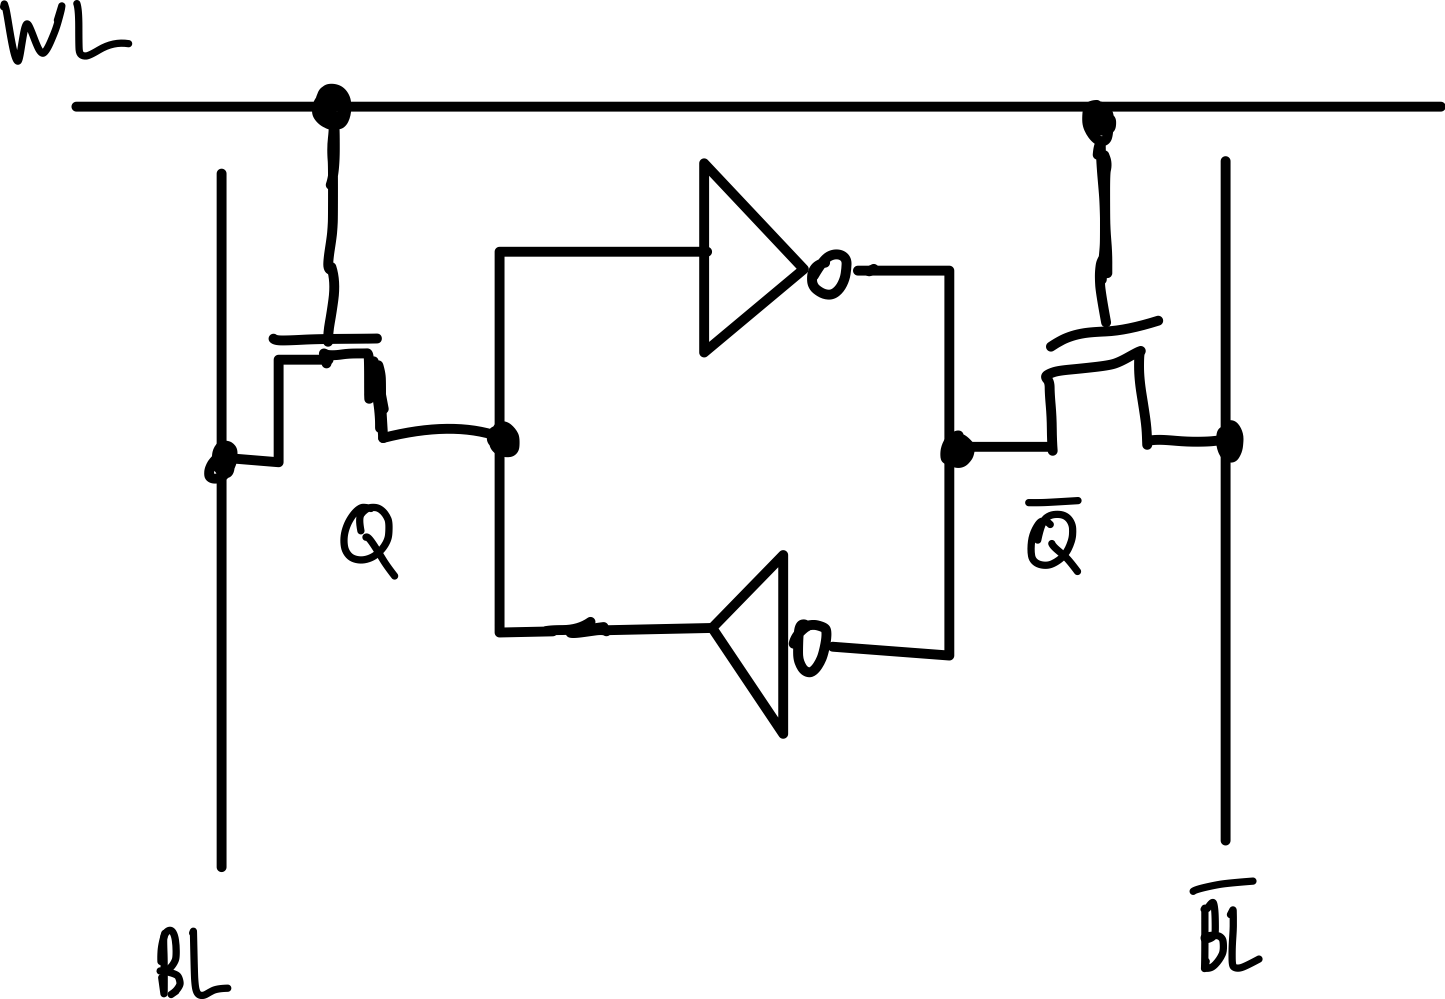
읽기와 쓰기 동작은 NMOS를 사용해서 만들 수 있다.
우선 아까봤던 인버터의 왼쪽 노드를 $Q$, 오른쪽 노드를 $\overline{Q}$라 하자.
두 노드를 연결하는 스위치로 NMOS를 붙인다.
$Q$, $\overline{Q}$ 양 옆에 비트라인 $BL$, $\overline{BL}$을 붙인다. 얘네가 쓰기 / 읽기 동작에서 신호를 제어하는 역할을 한다.
NMOS의 게이트 역할을 해줄 $WL$(Word Line)을 붙인다. 얘는 게이트 전압을 조절해서 쓰기·읽기 타이밍을 조절한다.
평소에는 $WL=0$으로 꺼져있으므로, NMOS가 동작하지 않는다. 이때는 한 셀에 값이 안정적으로 저장되어 있는 상태다.
쓰기
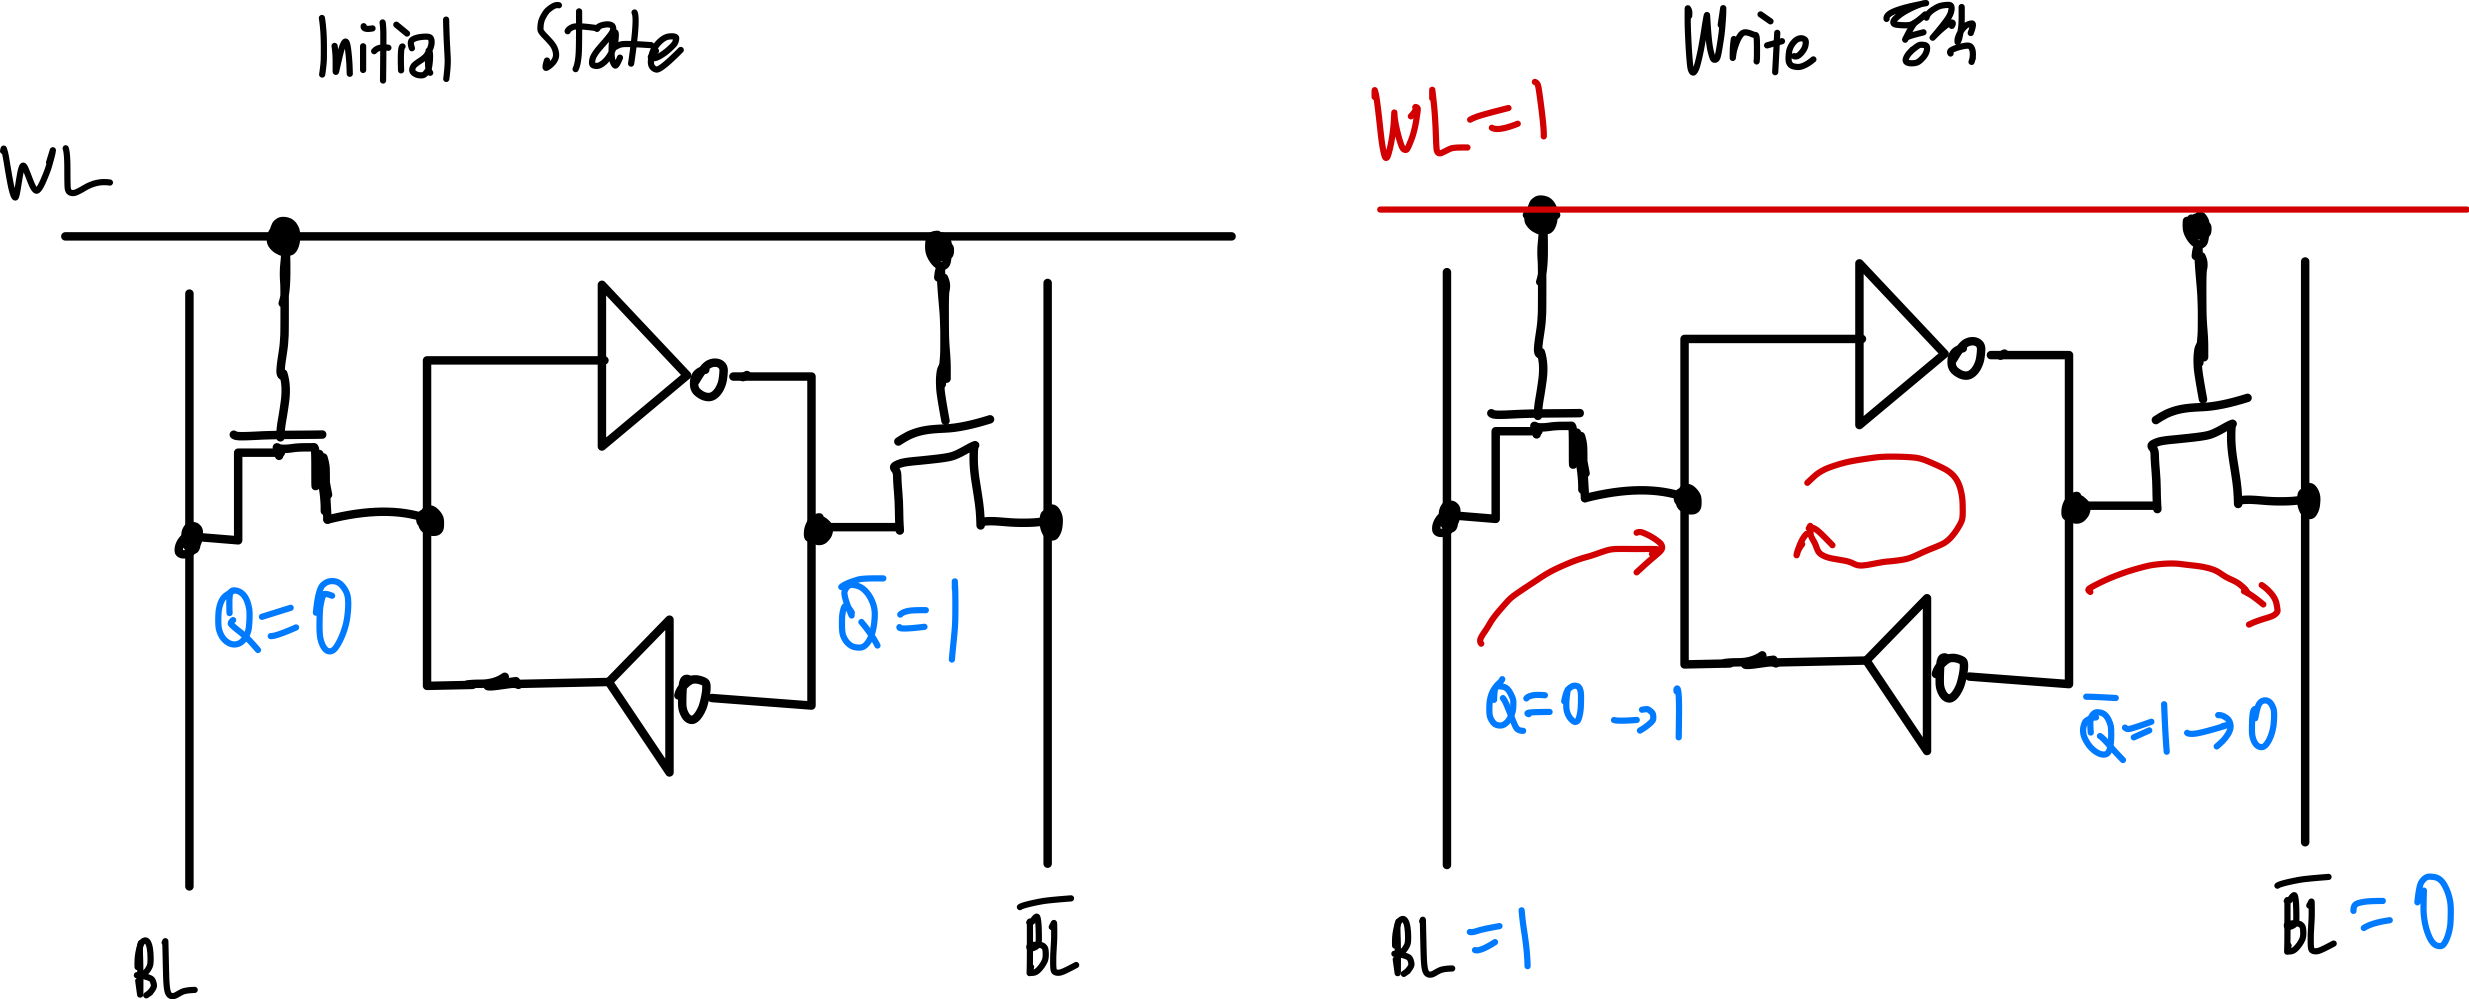
먼저 쓰기를 기준으로 동작해보자. $Q=0$, $\overline{Q}=1$을 초기 상태라 해보자.
쓰기 동작 시 $WL=1$로 활성화하여 NMOS를 연결시킨다.
$BL = 1$, $\overline{BL}=0$으로 전압을 준다. 전류는 전압이 높은 쪽에서 낮은 쪽으로 흐르므로 그림에서와 같이, $\overline{Q}=1$에서 $\overline{BL}=0$ 쪽으로 당겨진다. 곧 $\overline{Q}$의 state는 0으로 방전된다. 반대로 $Q$는 $BL=1$에서 전압을 공급받아서 $Q=1$로 state가 충전된다. $Q=1, \overline{Q}=0$으로 state가 확정되고 나면, $WL$을 비활성화해서 이 셀의 상태를 저장한다.
읽기
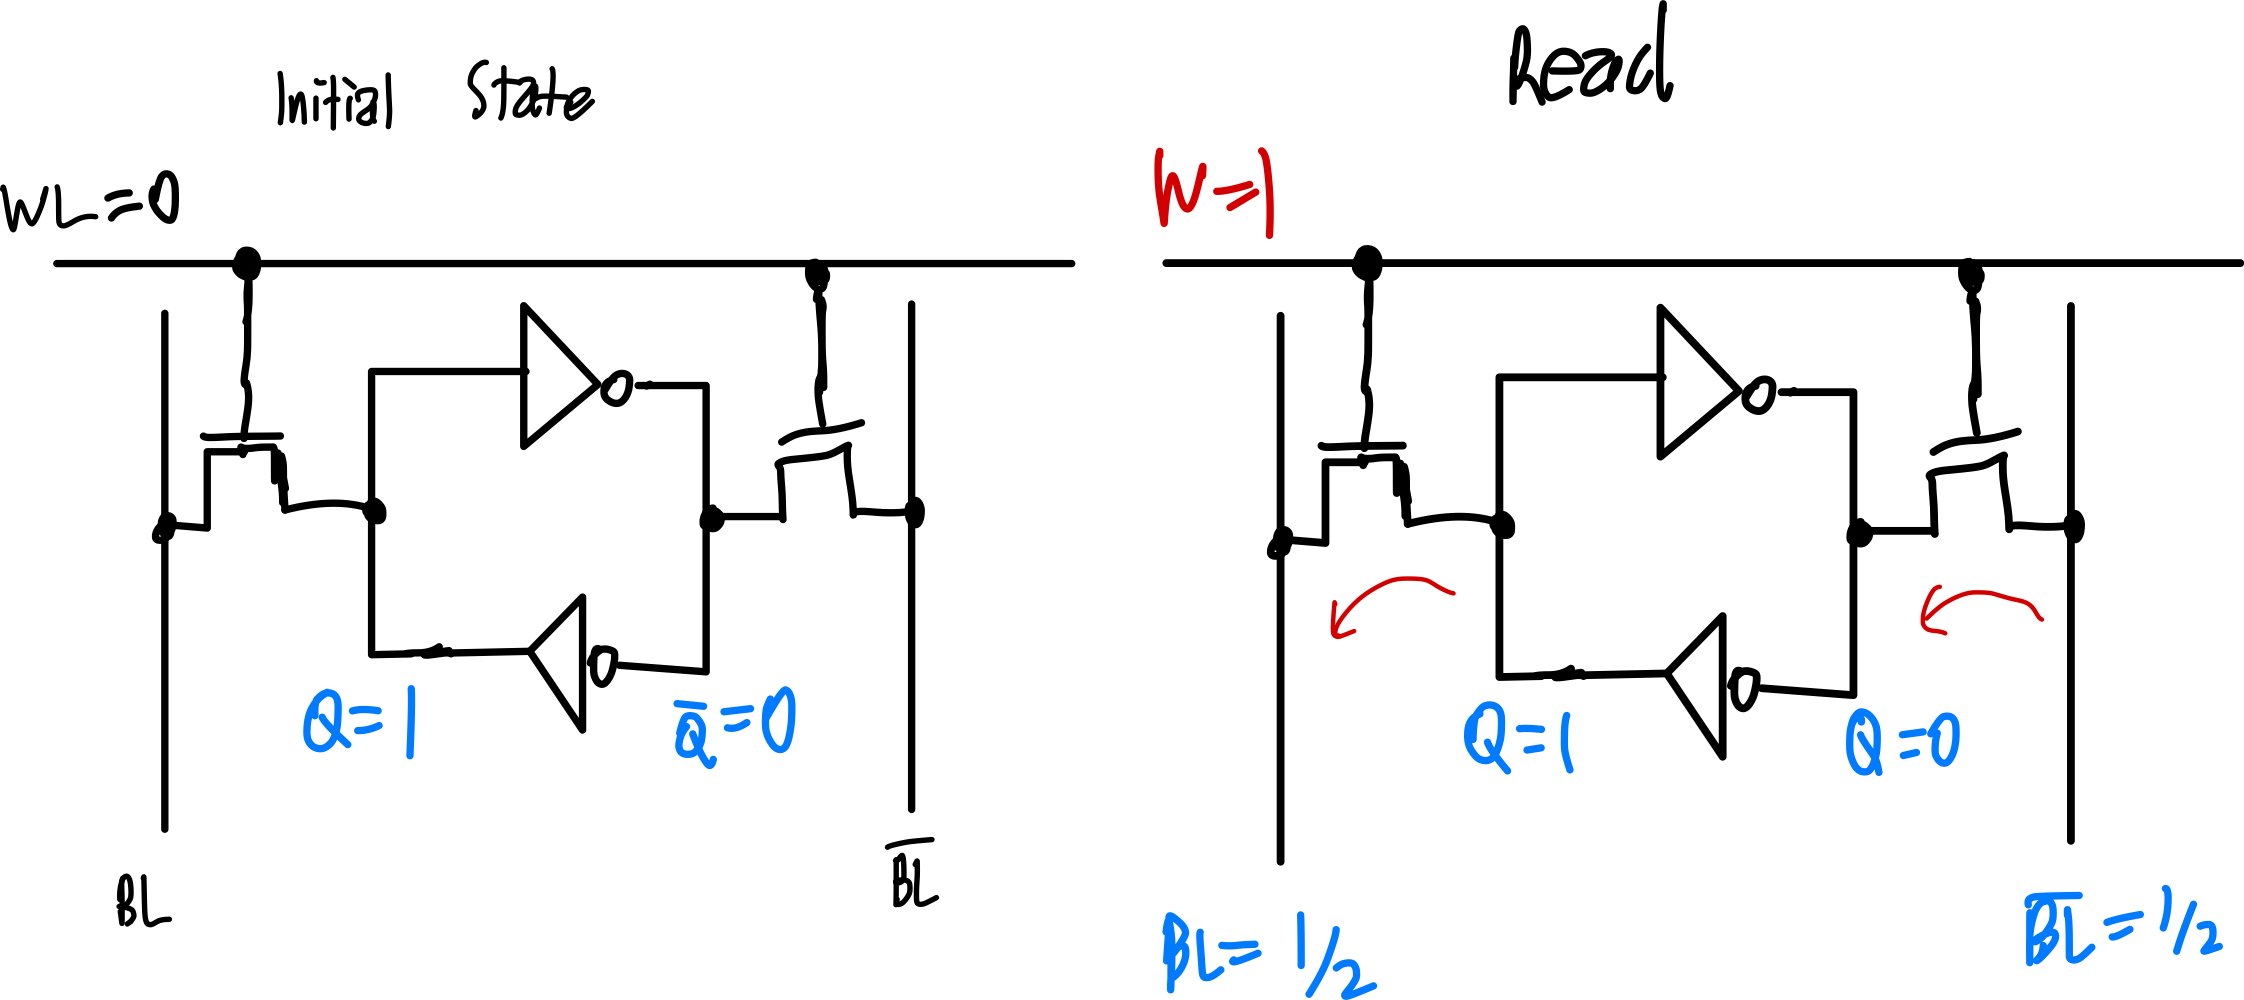
읽기 시에는 $BL=\cfrac{1}{2}$, $\overline{BL}=\cfrac{1}{2}$을 가한다. 똑같이 $WL=1$을 해서 연결시키자. $Q=1$, $Q=0$이다.
$WL=1$로 NMOS를 연결시키면, $BL=\cfrac{1}{2}$ 은 $Q=1$에 의해서 충전되면서 $\cfrac{1}{2}$보다 살짝 더 전압이 높아지게 된다. 반대로 $\overline{BL}=\cfrac{1}{2}$는 $\overline{Q}=0$에 의해 방전이 되면서 $\cfrac{1}{2}$보다 살짝 더 전압이 낮아지게 된다. 이 작은 차이를 앰프(Amplifier)가 증폭하여 0과 1의 큰 차이로 구분하게 되고, 이것을 읽어서 이 셀 안에 state가 0인지 1인지를 알게 된다.
비용과 성능
SRAM은 이론적으로 이렇게 해서 구현할 수 있다. SRAM의 장점은 안정적이고, 빠르다는 것이다.
CMOS Inverter 하나에 2개의 트랜지스터가 들어간다는 것을 기억하는가? SRAM 한 셀을 만드는 데 2개의 Inverter, 그리고 2개의 NMOS 트랜지스터가 들어가므로 총 6개의 트랜지스터가 들어간다. 이는 DRAM 대비 들어가는 트랜지스터 수가 늘어나서 비용이 높아지는 원인이 된다.
게다가 SRAM은 DRAM과 달리 리프레시 등의 비용이 없어서 훨씬 빠른 접근 시간을 가진다. 사실 SRAM에서 접근 시간은 사이클 시간과 거의 똑같다.
SRAM은 비싸지만 빠르고 안정적이기 때문에 L1, L2 등의 캐시 메모리로 사용되거나, CPU Register로 자주 사용된다.
DRAM
Capacity를 이용해 저장하기
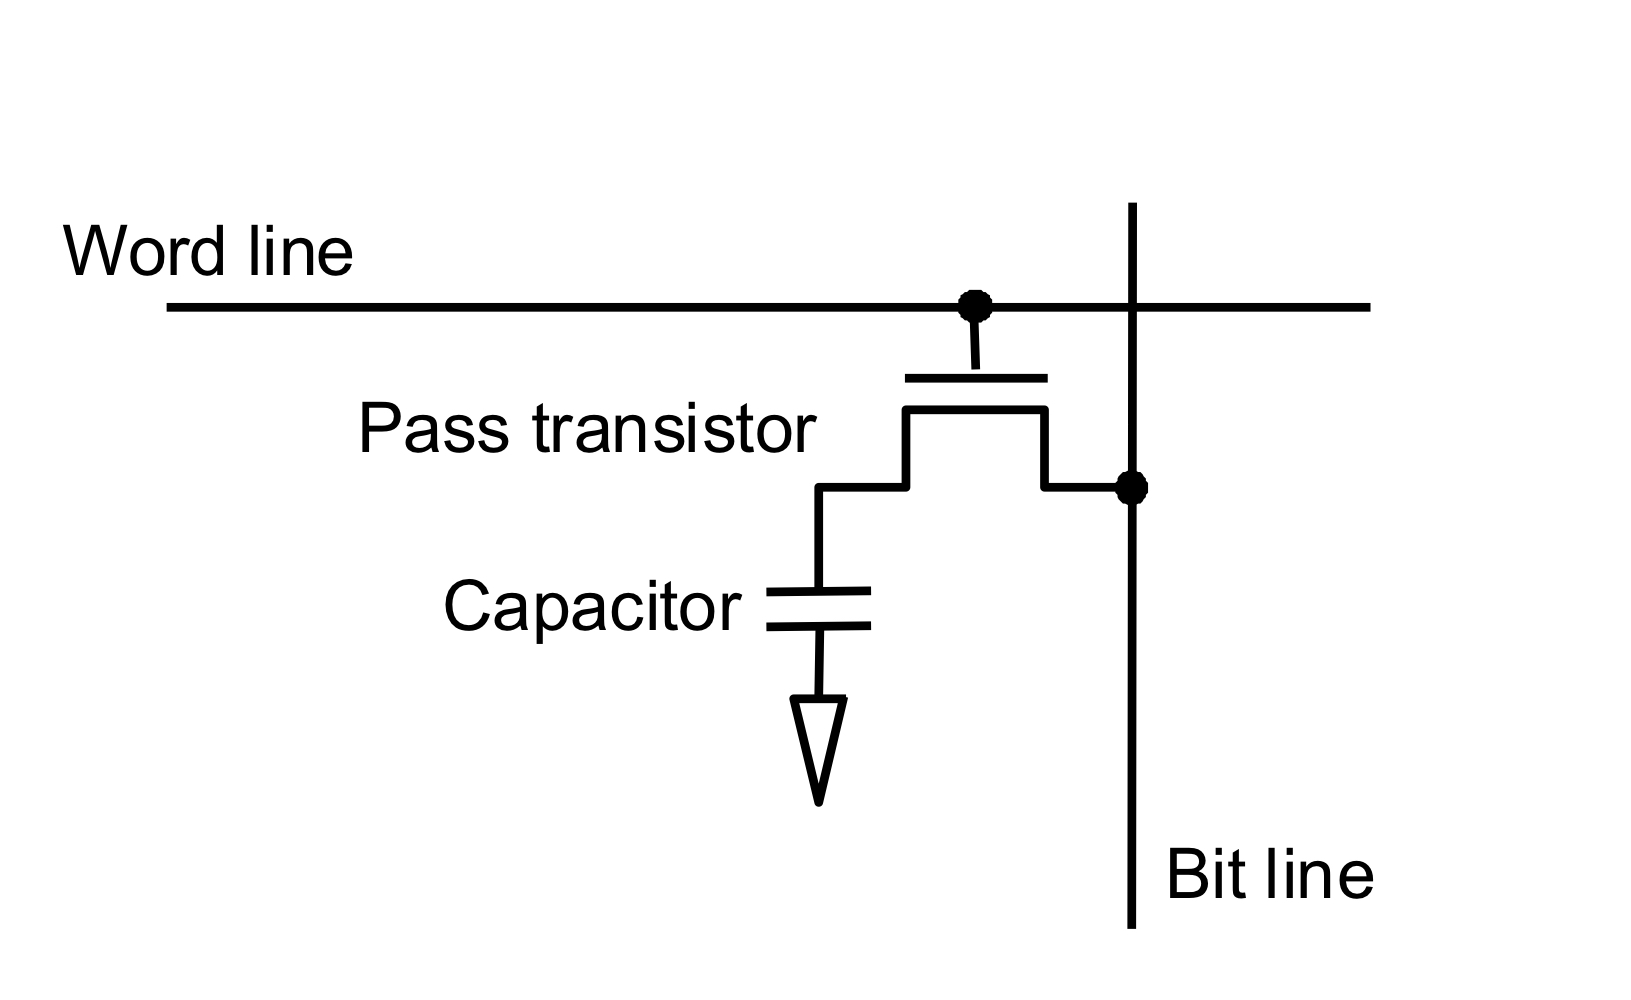
2개의 Inverter를 이용하는 SRAM과 달리 DRAM은 Capacitor를 이용해서 저장한다.
전력이 공급되는 한 그 값이 계속 안정적으로 유지되는 SRAM과 달리, Capacitor는 계속해서 누설 전류가 발생하고, 심지어 읽기 동작 그 자체도 Capacitor의 상태를 교란시킬 수 있어서 그 값이 매우 불안정하게 유지된다. 따라서 DRAM은 SRAM과 달리 지속적으로 리프레쉬(Refresh)라는 작업을 해줘야 한다. 이 차이점 때문에 Dynamic이라는 이름이 붙은 것이다. 동적으로 계속해서 리프레쉬를 해줘야 하기 때문이다. 반면 SRAM은 정적으로 상태가 유지되므로, Static이라는 이름이 붙는다.
한편 Capacitor의 정전 용량을 $C$라 할 때, 저장된 전하량 $q$에 대해서
$$
q= CV
$$
가 성립한다.
읽기와 리프레시
읽기
사실 쓰기, 읽기 동작의 원리는 SRAM과 원리가 비슷하다. $BL = \frac{1}{2}V$를 인가하고, $WL=1V$로 NMOS를 켜준다. 그 다음에 셀에 1이 저장되어 있었다면 캐퍼시터에서 BL로 당겨지면서 BL값이 0.5V보다 올라가고, 반대로 셀에 0이 저장되어 있었다면 캐퍼시터 쪽으로 당겨지면서 BL값이 0.5V보다 낮아지므로 이 차이를 증폭해서 0과 1을 결정한다는 건 동일한 원리이다.
쓰기 동작에서는 마찬가지로 1을 쓰고자 한다면 $WL=1V$를 인가하고 $BL=1$을 넣어서 캐퍼시터를 1로 충전시키면 된다. 반대로 0을 쓸 때에는 $BL=0$을 넣어서 캐퍼시터를 방전시키면 된다.
하지만 왜 DRAM에서 읽기가 문제가 되는 지 알아보기 위해서 간단히 계산을 직접 해보자.
Capacity의 정전용량 $C_{\text{cell}}=1C$이라 하자. 비트라인의 정전용량을 $C_{\text{BL}}=10C$이라 하자
NOTE: 읽기 시에는 비트라인에 계속 일정하게 전압을 가해서 유지하는 게 아니라, 비트라인을 충전한 이후에 공급을 끊고서 비트라인 전압의 변화를 관찰하는 것이기 때문에 당연히 정전용량이 존재해야 한다. 이때 이 정전용량을 대충 10배라고 가정한다
한편 연결 전 BL과 Capcitor 두 노드에 저장된 전하량의 합을 $q_0$라 하면
$$
q_0 = C_{\text{cell}}V_{\text{cell}}+C_{\text{BL}}V_{\text{BL}}
$$
이고, 연결된 이후의 전하량의 합을 $q_1$이라 하면, 두 노드는 같은 전압 $V_f$에 도달하므로
$$
q_1 = (C_{\text{cell}}+C_{\text{BL}})V_f
$$
이다. 이때 전하량 보존 법칙에 의해 $q_0= q_1$이므로
$$
C_{\text{cell}}V_{\text{cell}}+C_{\text{BL}}V_{\text{BL}}=(C_{\text{cell}}+C_{\text{BL}})V_f
$$
$$
V_f = \cfrac{C_{\text{cell}}V_{\text{cell}}+C_{\text{BL}}V_{\text{BL}}}{(C_{\text{cell}}+C_{\text{BL}})}
$$
초기에 설정해둔 값( $C_{\text{cell}}=1C$, $C_{\text{BL}}=10C$, $V_{\text{BL}} = \frac{1}{2}V$)을 대입해보자.
만약에 셀에 1이 저장되어 있어 $V_{\text{cell}}=1$이라면
$$
V_f = \cfrac{C\times 1V + 10C \times \frac{1}{2}V}{C+10C}=\cfrac{6}{11}V\approx 0.54545V
$$
이고 셀에 0이 저장되어 있어 $V_{\text{cell}}=0이면$
$$
V_f = \cfrac{C\times 0V + 10C \times \frac{1}{2}V}{C+10C}=\cfrac{5}{11}V\approx 0.45455V
$$
가 나온다.
비트라인 입장에서는 $V_{\text{BL}}=0.5V$에서 0.54545V가 되었으므로 $\Delta V_{\text{BL}}=+45.45mV$이고(혹은 셀이 0일 경우 $\Delta V_{\text{BL}}=-45.45mV$), 앰프가 이 신호를 증폭해서 캐퍼시터 안에 논리값이 1이었는지 0이었는지를 판별한다.
반면 셀의 입장에서는 기존에 $V_{\text{cell}}=1V$에서 $V_{\text{cell}}=V_f = 0.54545V$가 되었으므로, $q_{\text{cell}}=C_{\text{cell}}V_{\text{cell}}=1\times 0.54545$가 되어 1에서 반토막이 되는 걸 볼 수 있다.
이처럼 DRAM은 읽기 작업을 수행하는 것만으로 캐퍼시터에 저장된 값을 교란시키며, 이게 누적된다면 그 셀의 값을 읽지 못하게 된다. 따라서 DRAM은 읽기 작업 시 매번 리프레시 과정을 통해서 셀의 값을 충전시켜줘야 한다.
리프레시
Capacitor에서 상태가 보존되지 않는 DRAM의 단점을 보완하기 위해서, 1을 1로 충전해주고, 0은 확실히 0으로 방전시켜주는 리프레시를 계속해서 시행한다. 셀의 리프레시는 단순히 저장된 값을 읽어서 다시 써주면 된다.
DRAM에서 리프레시는 크게 두 타이밍에 실행되는데,
- 일단 읽은 후에는 읽기로 인해 셀이 교란되었으므로 이때 해당 셀에 대해서 리프레시를 한 번 해줘야 하고,
- 또한 읽지 않은 셀이라도 시간이 지남에 따라서 Capacitor 자체에서 전하량 자체가 누설되어서 상태가 변하므로 주기적으로 모든 셀을 리프레시해줘야 한다. 이를 주기적 리프레시라 한다.
참고로 읽기 동작 후 리프레시하는 것하고, 주기적 리프레시는 별개의 동작이다.
전하는 일반적으로 수 ms 동안 유지될 수 있다고 알려져 있다. 그런데 매번 하나의 셀을 읽을 때마다 리프레시를 하게 된다면, DRAM 메모리 컨트롤러는 정작 메모리에 저장된 값에 접근할 여유도 없이, 리프레시하는 데 거의 모든 시간을 다 쏟고 말 것이다.
DRAM의 내부구조
뱅크
이 비효율성을 해결하기 위해서 DRAM은 뱅크 구조를 갖는다. DRAM은 2단계 디코딩 구조를 갖고 있어서, 전체 행을 한꺼번에 읽고 나서 바로 쓰기 작업을 실행하여 한 행을 한 번에 리프레시할 수 있다.
이때 DRAM에서 한 행에 있는 셀들은 워드라인 WL을 공유한다. 이 WL이 켜지면 한 행의 모든 셀의 NMOS가 활성화되기에, 한꺼번에 병렬적으로 한 행을 리프레시할 수 있는 것이다. 이 과정을 한 행을 연다 or 활성화한다 or 읽는다고 표현하겠다.
한편 이렇게 한꺼번에 읽어들인 행을 유지하는 버퍼를 행 버퍼(row buffer)라 한다. DRAM은 성능 향상을 위해 행을 버퍼링해서 반복적으로 접근한다. 이때 이 버퍼는 SRAM처럼 동작한다. SRAM은 각 셀에 개별적으로 접근할 수 있으므로, 버퍼 내에서는 특정 주소값의 비트를 바로 접근할 수 있다. 단, 접근하고자 하는 비트 주소가 다음 버퍼에 있다면 해당하는 버퍼 행을 읽어야 접근할 수 있다.
이때 closed row를 활성화하는 단계는 PRECHARGE → ACTIVATE → READ 단계로 구분할 수 있다. PRECHARGE은 기존에 열려있던 row를 닫고, 다음 활성화에 필요한 비트라인을 준비하는 동작이다. 메모리 컨트롤러에서 이 과정을 수행하는데, PRECHARGE와 ACTIVATE, 그리고 명령 사이에는 각각 최소 대기 시간이 필요하다.
| Bank | State |
| Bank 0 | row 100 ACTIVATE |
| Bank 1 | row 200 활성화 중 |
| Bank 2 | PRECHARGE |
| Bank 3 | Closed |
이 행들이 모여서 하나의 뱅크(Bank)를 이룬다.
뱅크를 나눠서 관리하게 되면, 각 뱅크마다 별도의 행 버퍼를 두어서, 서로 다른 행을 활성화하여 접근할 수 있다. 예컨대 4개의 뱅크가 있다고 치면, 한 번의 접근 사이클에 4개의 뱅크를 돌아가면서 접근해서 4배의 대역폭을 확보할 수 있을 것이다. 이러한 접근 방식을 주소 인터리빙(address interleaving)이라 한다.
뱅크 구조는 굳이 리프레시 때문만이 아니더라도, 여러 이점 때문에 DRAM 내부 구조로 채택되고 있다.
SDRAM
한편 DRAM에 클럭을 추가한다면, 메모리와 프로세서를 동기화하는 시간을 없앨 수 있다. 이를 SDRAM(Synchronous DRAM)이라 한다. SDRAM은 주소를 하나하나 지정하는 대신, 연속적인 비트들을 버스트 모드로 전송한다. 버스트 모드란 시작 위치를 지정한 뒤 여러 데이터를 연속적으로 전송하는 방식을 말한다. 이 방식으로 매번 CPU에서 DRAM으로 특정 주소에 대해서 읽기 명령을 반복할 필요가 없다.
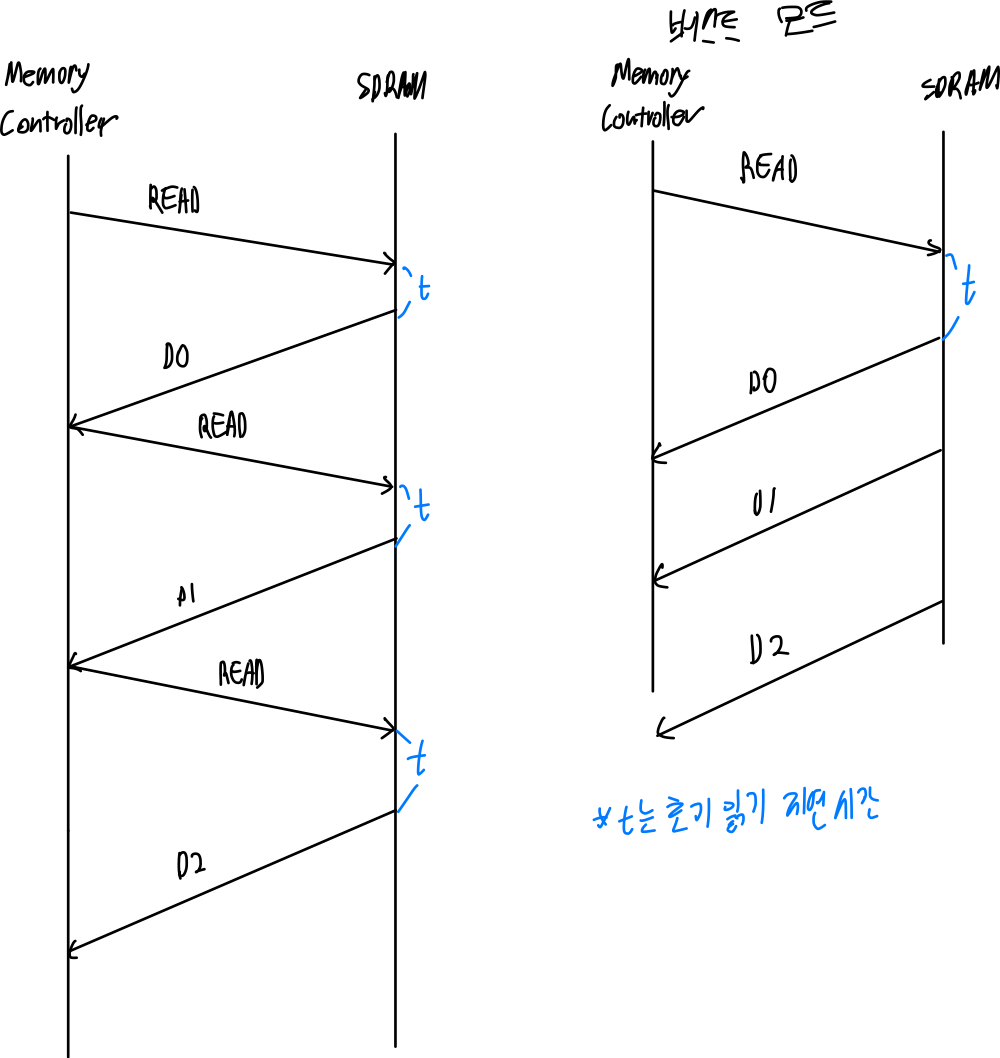
한편 1 clock cycle 안에는 상승과 하강(rising edge와 falling edge)이 있는데, 컴퓨터 구조 시간에 배우지만 메모리 컨트롤러는 rising/falling edge 둘 다 읽기/쓰기 접근이 가능하도록 설계할 수 있다.
이 기술을 이용한다면 같은 클럭이라 하더라도 대역폭이 2배가 된다. 이러한 메모리를 DDR(Double Data Rate) SDRAM이라 하며, 현재는 DDR5 기술이 나와있다.
비용과 성능
리프레시라는 치명적인 단점을 갖고 있음에도 DRAM을 사용하는 이유는 그 비용에 있다. DRAM은 한 셀에 하나의 NMOS 트랜지스터와 캐퍼시터만 갖고서 만들 수 있다. 곧 DRAM은 1T1C, SRAM은 6T의 비용이 발생한다.
이 때문에 DRAM은 SRAM 대비 대용량으로 데이터를 저장하기 유리하며, 그때문에 메인 메모리 기술로 DRAM을 사용한다. 오늘날 DRAM은 일반 컴퓨터에서 16GB, 많게는 128GB 이상 사용되기도 한다. 반면 레지스터나 캐시 메모리로 사용되는 SRAM같은 경우 수 KB ~ 수 MB 수준에 머문다.
뱅크 구조 등의 설계로 그 한계를 극복하기는 했으나 태생적으로 DRAM은 SRAM보다 싼 대신 느릴 수 밖에 없다. 때문에 이러한 병목 현상을 극복하기 위해서, CPU register와 main memory 사이에는 Cache 메모리로 채운다. 오늘날 L1, L2, L3 Cache까지 촘촘히 채워놓아서, main memory의 성능 한계를 극복하고 있다.
본 글에서는 불안정한 구조를 가진 DRAM에서 어떻게 저장된 데이터를 손실 없이 유지하는 지 - 리프레시에 대해서 알아봤다.
한 가지 슬픈 사실은 이렇게 꼼꼼히 리프레시를 해서 데이터를 유지하더라도, 여전히 오류가 발생할 수 있다! 이는 리프레시와는 별개의 문제로, 데이터를 읽는 과정에서 잘못 읽어들일 수 있다. 다음 글에서는 이 문제에 대해서 다뤄볼 예정이며, 이 문제를 극복하기 위한 ECC 기술에 대해서 알아볼 예정이다.
참고 문헌
- Patterson, D. A., & Hennessy, J. L. (2022). 컴퓨터 구조 및 설계: RISC-V Edition (장훈, Trans.; 2nd Edition). 한티미디어.